Seguro que ya te has cruzado con el término "Company Brain".
Apareció en un ensayo de un VC, luego en un repositorio viral, después en una Request for Startups de Y Combinator, y ahora ocupa la mitad de los hilos sobre IA de tu timeline. En algún punto entre el quinto y el décimo post, probablemente asentiste sin poder decir qué es en realidad.
Por eso, para algunas personas, un Company Brain significa un grafo de contexto, un mapa conectado de todo lo que produce una empresa. Para otras significa una búsqueda empresarial con mejores modales.
Para otras es un wiki que se actualiza solo, la versión para empresas de lo que Andrej Karpathy construyó para sus propias lecturas, o de lo que Garry Tan publicó en código abierto como GBrain. Cada una de estas cosas es una pieza real. Ninguna es el conjunto completo.
En este artículo intentaremos darte un repaso de qué es, de dónde viene y por qué todo el mundo quiere uno.
Nuestras estadísticas sobre company brains muestran que el 70% de los equipos conoce el término, mientras que solo el 20% tiene uno.
Puntos clave
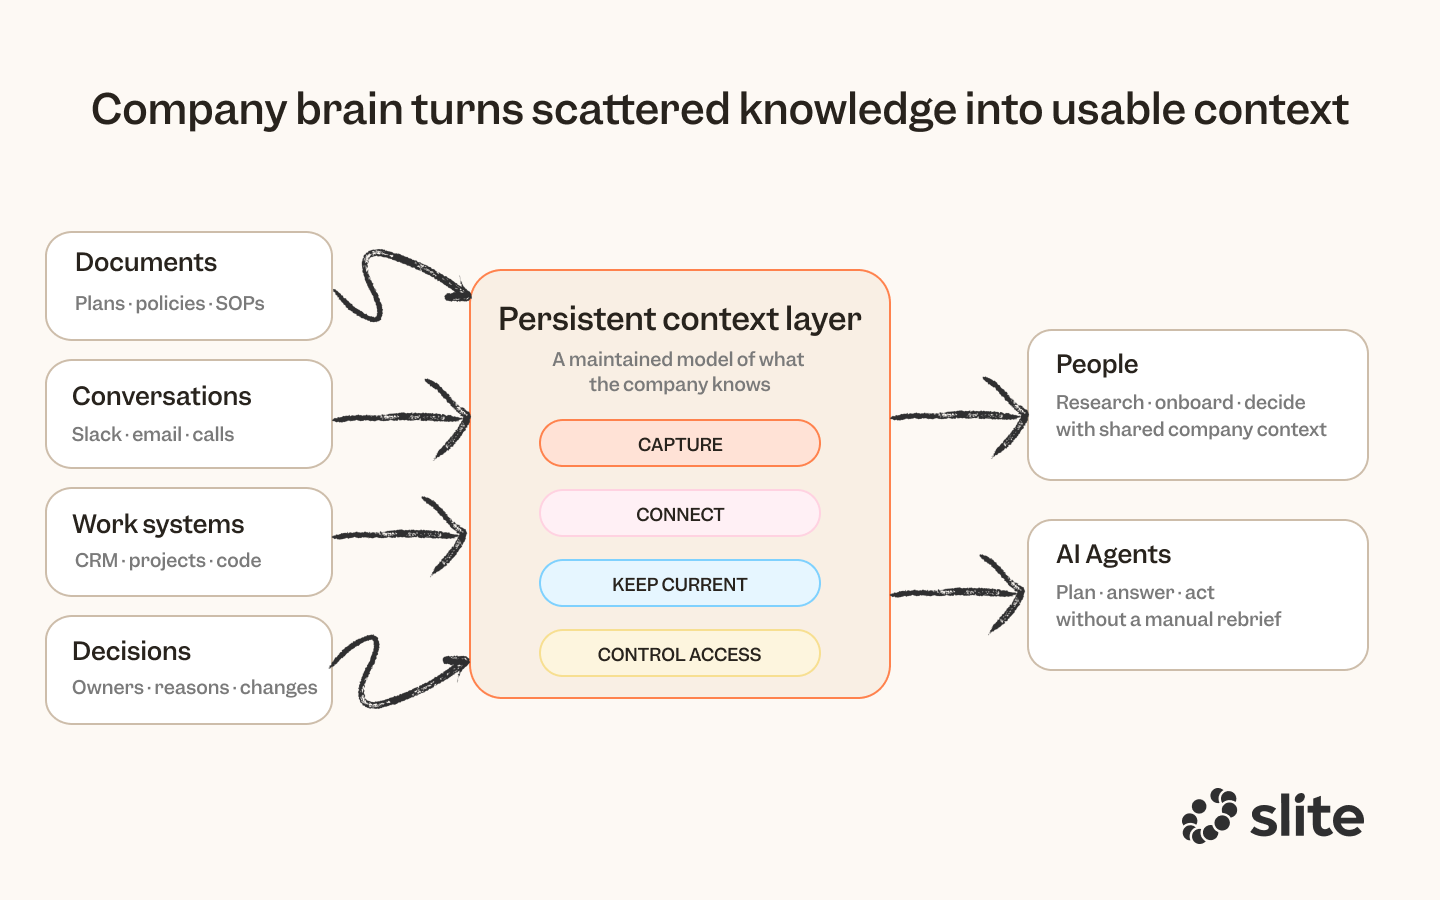
- Un Company Brain es una capa de contexto persistente que reúne el conocimiento allí donde una empresa lo crea y hace que ese contexto sea utilizable tanto por personas como por agentes de IA.
La práctica de ensamblar ese contexto para un modelo se llama context engineering.
- Importa ahora porque los agentes cambiaron lo que está en juego: las personas pueden sortear la falta de contexto, pero los agentes solo saben lo que les entregas y lo olvidan entre sesiones, así que la dispersión del contexto pasó de ser una molestia a ser una dependencia.
- El término convergió desde varios hilos en aproximadamente un año: el "second brain" personal, la búsqueda empresarial, los grafos de contexto de Foundation Capital (diciembre de 2025), el wiki LLM de Karpathy, el GBrain de código abierto de Garry Tan y la Request for Startups del verano de 2026 de YC.
- Es una categoría propia, distinta de la búsqueda empresarial y de un chatbot pegado a un wiki. Su verdadero trabajo es capturar el "por qué" detrás de las decisiones, en lugar de limitarse a recuperar documentos.
- Los brains personales y los Company Brains se separan en la propiedad: un brain personal sirve a una sola persona, mientras que un Company Brain añade permisos, gobernanza, fuentes en conflicto y confianza compartida.
- Elige una herramienta personal o de código abierto cuando la memoria es tuya o tu equipo es pequeño y unido; elige un Company Brain gestionado como Slite cuando los niveles de acceso difieren, las fuentes se contradicen, hay datos sensibles en juego o los agentes pueden ejecutar acciones.
Company brain: la definición de trabajo
Un company brain es una capa de contexto persistente. Reúne el conocimiento allí donde una empresa lo crea, y hace que ese contexto sea utilizable tanto por personas como por agentes de IA.
Los problemas de fondo son viejos y poco glamurosos:
- La información se dispersa.
- La memoria institucional se va con las personas.
- Los documentos se quedan obsoletos y nadie se da cuenta.
Esto crea dispersión del contexto, pero los humanos siempre han sabido sortearla.
Lo que cambió en el último año es quién necesita la respuesta.
Las personas son excelentes sorteando la falta de contexto. Le preguntas a la persona que tienes al lado.
Un agente no hace nada de eso. Solo sabe lo que le entregas, y lo olvida entre sesiones a menos que algo recuerde en su nombre.
Así que una molestia se convirtió en una dependencia en el momento en que la gente empezó a dar instrucciones a agentes para hacer trabajo real.
Se supone que un company brain resuelve la dispersión del contexto dando a los agentes toda la información relevante sobre tu empresa.
¿De dónde viene el company brain?
Antes de que nadie usara la expresión, dos deseos distintos llevaban años en el mercado, cada uno con su propio público, sus propias herramientas y ninguna razón real para encontrarse.
La aparición del Second Brain
La gente quería conservar lo que leía, aprendía, creaba y observaba. Tiago Forte fue quien más visiblemente popularizó el método moderno del second brain, y toda una generación de personas que toman notas construyó sistemas a su alrededor.
Pero la promesa más profunda era más silenciosa y más emocional. Si capturabas suficiente de tu propio pensamiento y lo conectabas bien, quizá por fin podrías ver la forma de tu propia mente desde fuera.
Luego llegó la búsqueda empresarial a finales de los 2010
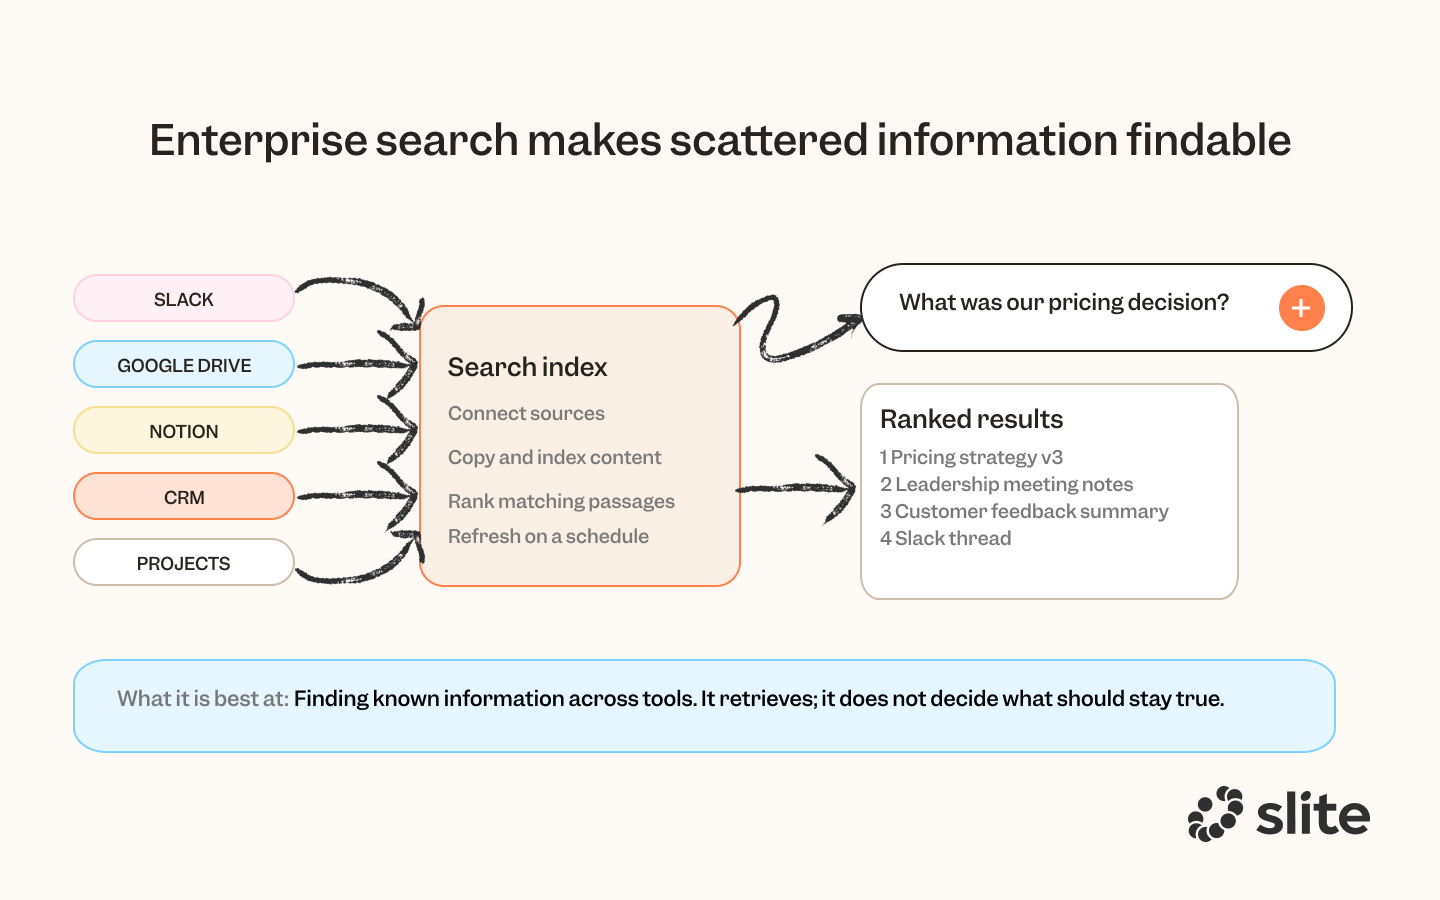
Las empresas tenían información dispersa mucho antes de tener IA. Las mismas cinco preguntas se repetían en cada onboarding de una nueva incorporación. La búsqueda empresarial fue la respuesta: hizo que las cosas se pudieran encontrar en herramientas que no tenían ningún interés en hablar entre sí.
Lo que nunca hizo fue mantener nada. Recuperaba. No conservaba un modelo actualizado de cómo funciona la empresa, y desde luego no guardaba ese modelo en una forma sobre la que otro sistema pudiera actuar.
Así que un deseo tenía que ver con la memoria de una persona, y el otro con el acceso de una empresa. Permanecieron separados porque nada los obligaba a juntarse. Luego, en aproximadamente un año, pasaron cuatro cosas que sí lo hicieron.
En 2025, una firma de VC acuñó los Context Graphs
El 22 de diciembre de 2025, Jaya Gupta y Ashu Garg, de Foundation Capital, publicaron un artículo que sostenía que los grafos de contexto eran una oportunidad enorme. El enfoque que importaba iba más allá de "almacenar más datos de la empresa": la mayoría de los sistemas solo conserva una parte de un proyecto más grande, y ninguno de ellos, en conjunto, forma el contexto de por qué algo ocurrió en primer lugar.
Por ejemplo, imagina que inicias un nuevo proyecto de marketing a partir de una charla junto a la máquina de café con tu manager.
- Su documento de propuesta estará en Slite
- Su progreso estará en Notion, ClickUp, Asana
- Sus recursos de trabajo estarán en Figma y Google Docs
- Su seguimiento estará en BigQuery y Google Analytics
Una IA podría recuperar esas cosas, pero no puede recuperar las charlas junto a la máquina de café ni los hilos de Slack donde realmente se tomaron las grandes decisiones durante la ejecución.
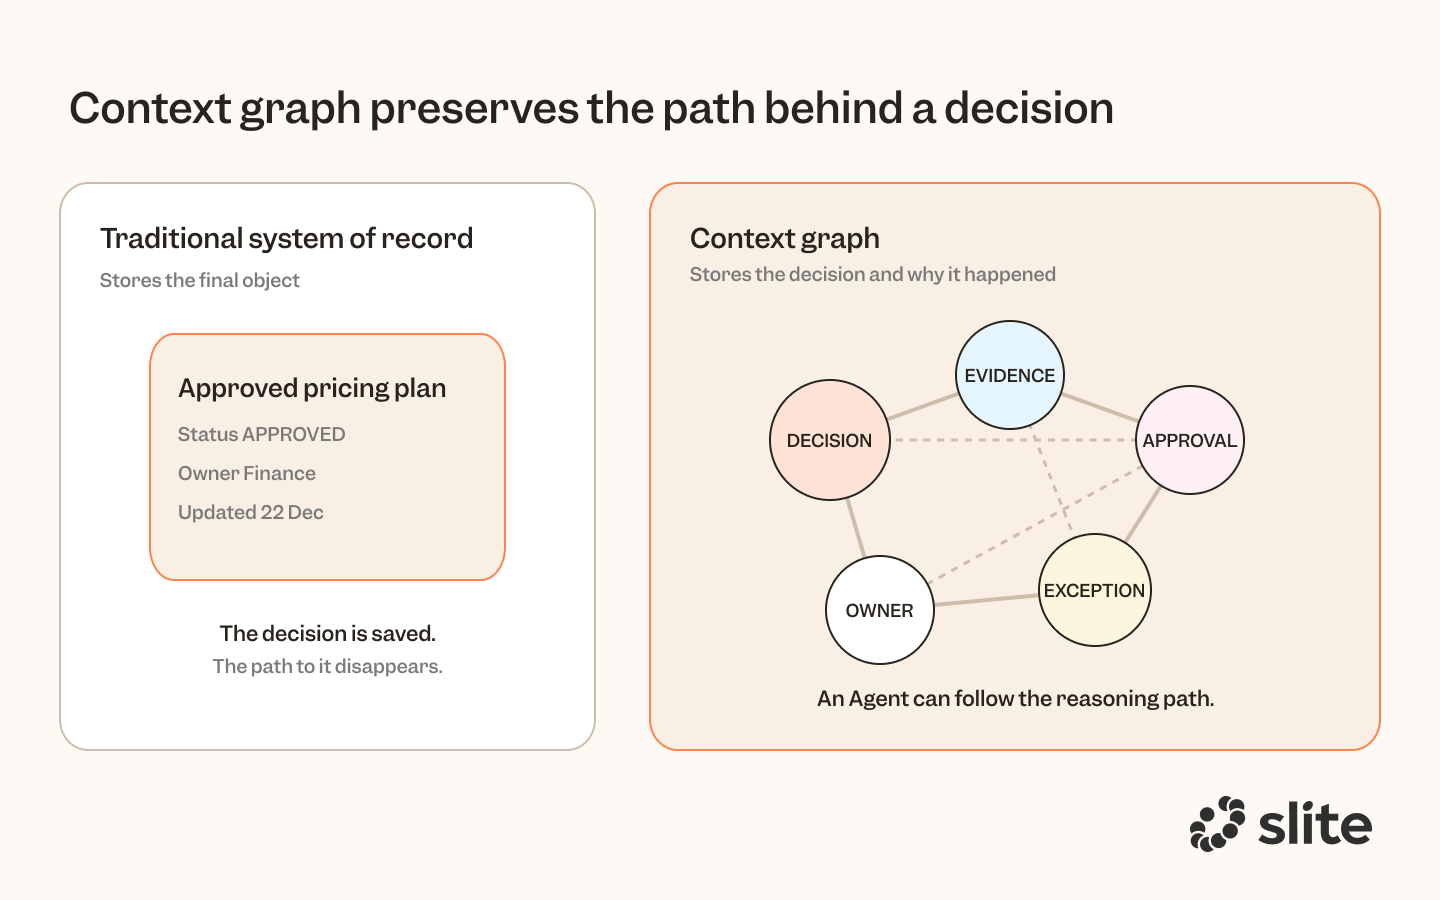
Así que Jaya y Ashu sostenían que las empresas necesitaban un Context Graph que una tu información para inferir el contexto de por qué hiciste algo y por qué decidiste hacerlo así. Si los agentes no tienen eso como evidencia empírica, nunca podrán hacer las mismas consideraciones que hace tu equipo al planificar o idear.
Andrej Karpathy propuso un wiki LLM
En abril, Karpathy propuso una capa persistente situada entre las fuentes en bruto y la recuperación, donde un modelo lee continuamente lo que entra y lo sintetiza en un conjunto de páginas interconectadas y navegables. Lo planteó para la lectura personal, la investigación y el uso empresarial, lo que señalaba discretamente que la misma maquinaria funcionaba a cualquier escala.
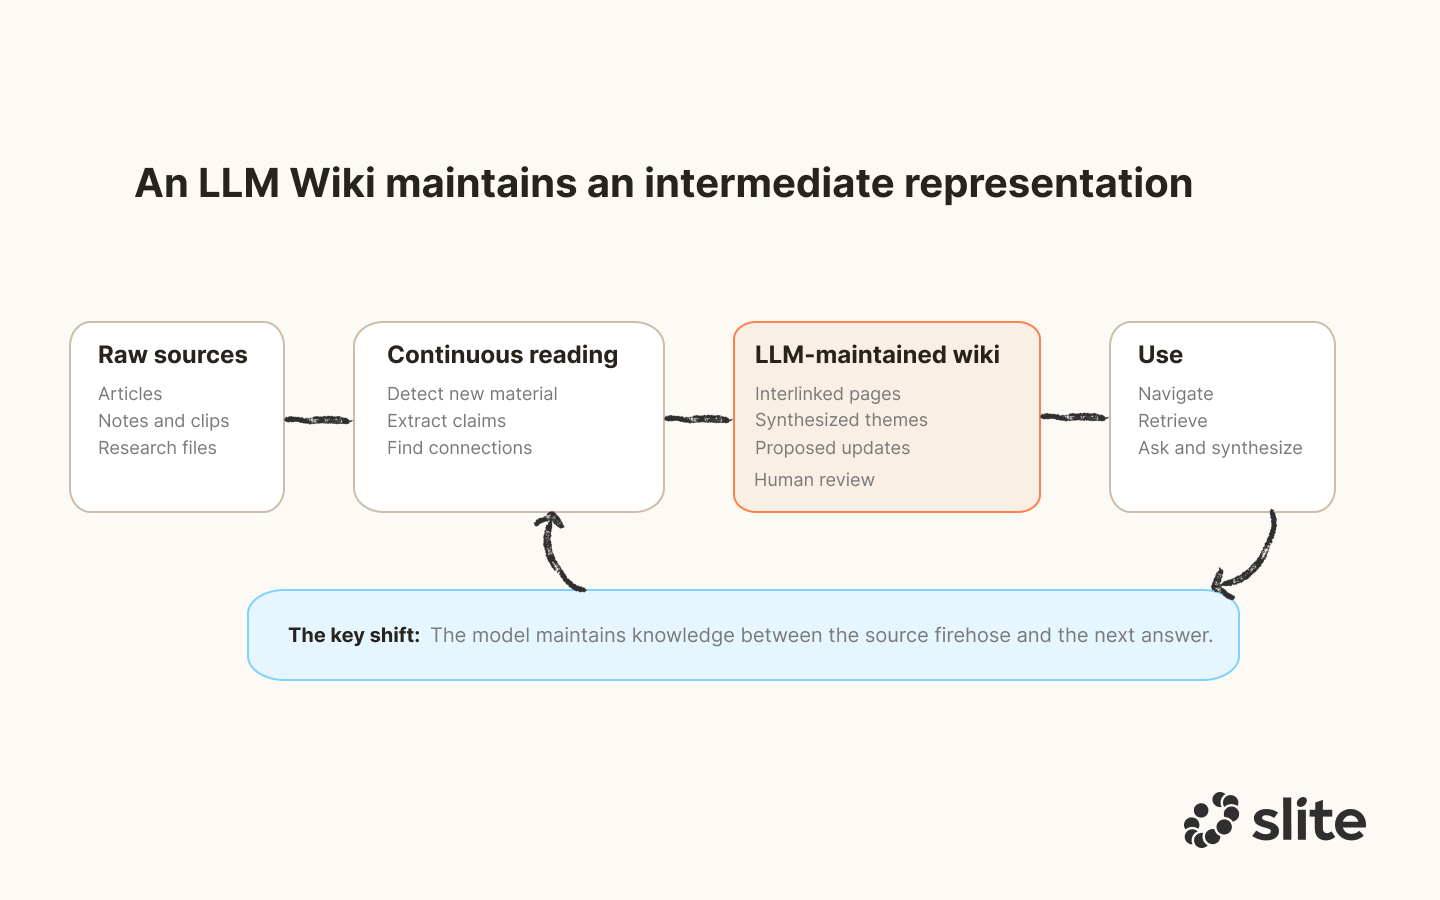
Hizo que una idea abstracta fuera lo bastante concreta para construir sobre ella, y provocó experimentos.
→ Lee más: Base de conocimientos LLM: cómo construir una que realmente funcione (2026)
Luego llegó GBrain
Garry Tan construyó GBrain para servir a sus propios agentes, alimentándolo con reuniones, correos y cualquier otra cosa que pasara por su día, para que los agentes que trabajaban en su nombre tuvieran algo con lo que trabajar. Ingería, enriquecía, consolidaba y seguía funcionando mientras él no miraba.
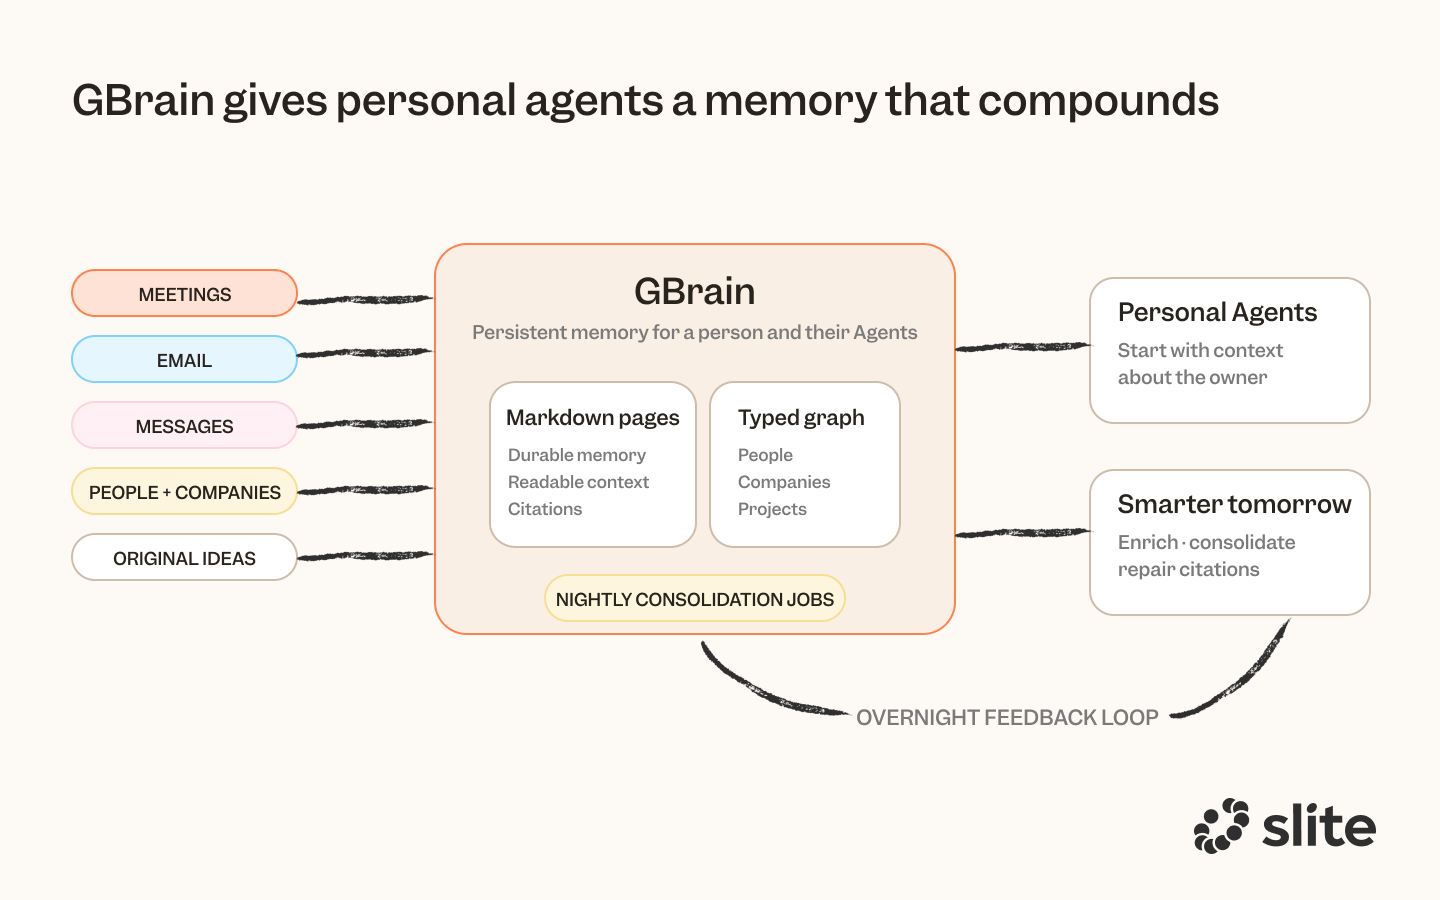
Como implementación de código abierto, convirtió la memoria persistente de una persona y sus agentes en algo que podías leer, ejecutar y discutir. Más tarde el proyecto se amplió para cubrir casos de uso de company brain.
La RFS de YC consolidó todo lo anterior en un Company Brain
La Request for Startups del verano de 2026 de Y Combinator incluía una entrada de Tom Blomfield titulada Company Brain, que citaba GBrain directamente y pedía "el G-Brain de Garry, pero para todas las empresas del mundo".
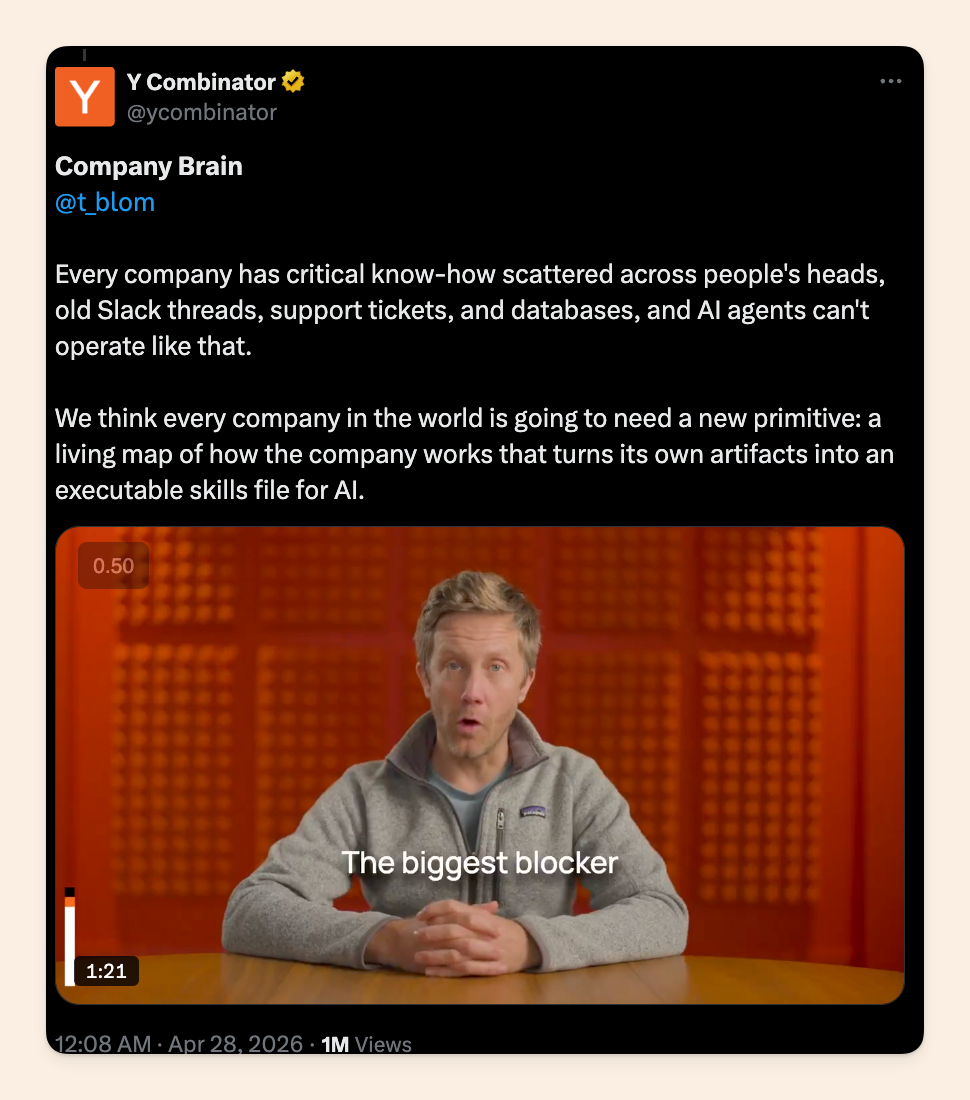
La entrada también decía con claridad lo que la categoría no es: una búsqueda de empresa, o un chatbot pegado a un wiki. Observaba explícitamente, e infería con acierto, que un Company Brain es una categoría nueva con sus propios retos, y que hace falta un esfuerzo dedicado para construirlo.
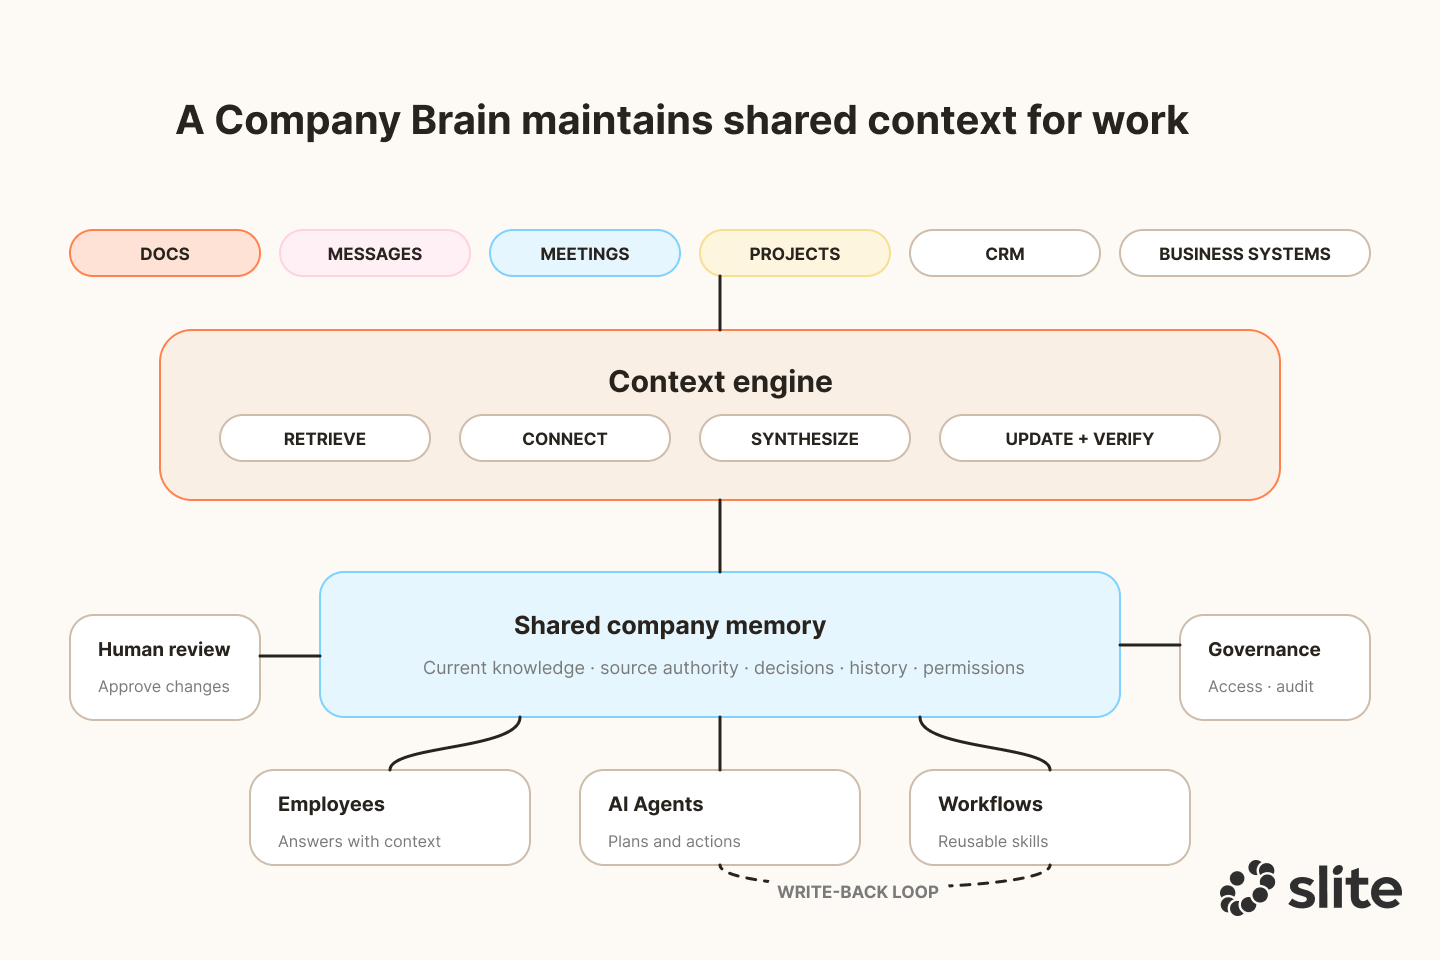
La memoria personal aportó la ambición de un sistema que lee y sintetiza en tu nombre.
El conocimiento empresarial aportó la escala y los problemas poco glamurosos.
El contexto de las decisiones aportó aquello que merece la pena almacenar.
Los agentes aportaron el consumidor, la razón por la que ahora todo esto tiene que ser legible por máquinas y estar actualizado, en lugar de ser simplemente buscable.
¿Por qué todo el mundo quiere un brain?
El atractivo viene de dos direcciones a la vez, así que conviene separar lo que las empresas realmente quieren de por qué la versión personal resulta tan emocionante.
Lo que quieren las empresas
Las empresas quieren que el contexto persista entre sesiones, se transfiera a nuevos empleados y agentes, revele conexiones entre equipos y siga siendo útil sin que alguien esté limpiando constantemente una base de conocimientos.
Todas estas necesidades apuntan al mismo resultado. El contexto de la empresa debería persistir, viajar y mejorar.
Por qué los brains personales resultan tan emocionantes
Un brain personal promete que todo lo que has leído, escrito, visto, subrayado o que te ha obsesionado brevemente puede reunirse y conectarse. Por fin tendrías tu propia torre de Babel, con cada piso construido a partir de algo que una vez consumiste o creaste.
Te ayuda a recordar, pero el atractivo más profundo es poder verte a ti mismo desde fuera.
Hasta hace poco, construir esta estructura significaba elegir carpetas, añadir etiquetas, crear enlaces y mantener el sistema tú mismo. Los LLM cambiaron ese trato. Podían leer lo que consumías, conectarlo, resumirlo y mantener la estructura en tu nombre.
El second brain dejó de parecer un hábito de archivo y empezó a parecer un software capaz de pensar a tu lado.
Dónde se separan los brains personales y los Company Brains
Un Company Brain hereda la promesa de la memoria persistente y luego la hace operativa. Debe mapear lo que sabe una organización, informar a empleados y agentes, respetar permisos, resolver fuentes en conflicto y tener en cuenta decisiones que cambian con el tiempo.
Antes de lanzarte a desplegar algo o a mirar listas de los 10 mejores, merece la pena reflexionar sobre los detalles y entender si realmente quieres un company brain para tu equipo o si solo te interesa un brain personal.
| Brain personal | Company Brain | |
|---|---|---|
| A quién pertenece | A una persona | A un equipo o una empresa |
| Qué contiene | Notas, lecturas, ideas, correos y archivos personales | Documentos, conversaciones, reuniones, proyectos, datos de clientes y herramientas de la empresa |
| Para qué ayuda | Recordar, sintetizar y comprenderse a uno mismo | Trabajo compartido, onboarding, decisiones y automatización |
| Quién decide qué es verdad | Tú | Varios propietarios y fuentes |
| Quién puede acceder | Normalmente solo tú | Empleados y agentes con permisos diferentes |
| Qué lo mantiene | Tus preferencias y hábitos | Reglas de la empresa, propietarios y sistemas automatizados |
| Qué pasa cuando se equivoca | Recibes una mala respuesta | Un contexto incorrecto puede afectar a todo un flujo de trabajo |
| Qué es lo más importante | Utilidad personal | Precisión, acceso, gobernanza y confianza |
Si el conocimiento es tuyo y un error solo te molesta a ti, probablemente quieres un brain personal.
En cuanto ese contexto debe ser compartido, estar sujeto a permisos, mantenerse y ser confiable para otras personas o agentes, estás construyendo un Company Brain.
¿Cuál necesitas?
Empieza por dónde tiene que viajar el contexto.
Comparamos diez soluciones de company brain reales, desde repositorios de código abierto hasta productos gestionados, si quieres ver las opciones una al lado de la otra.
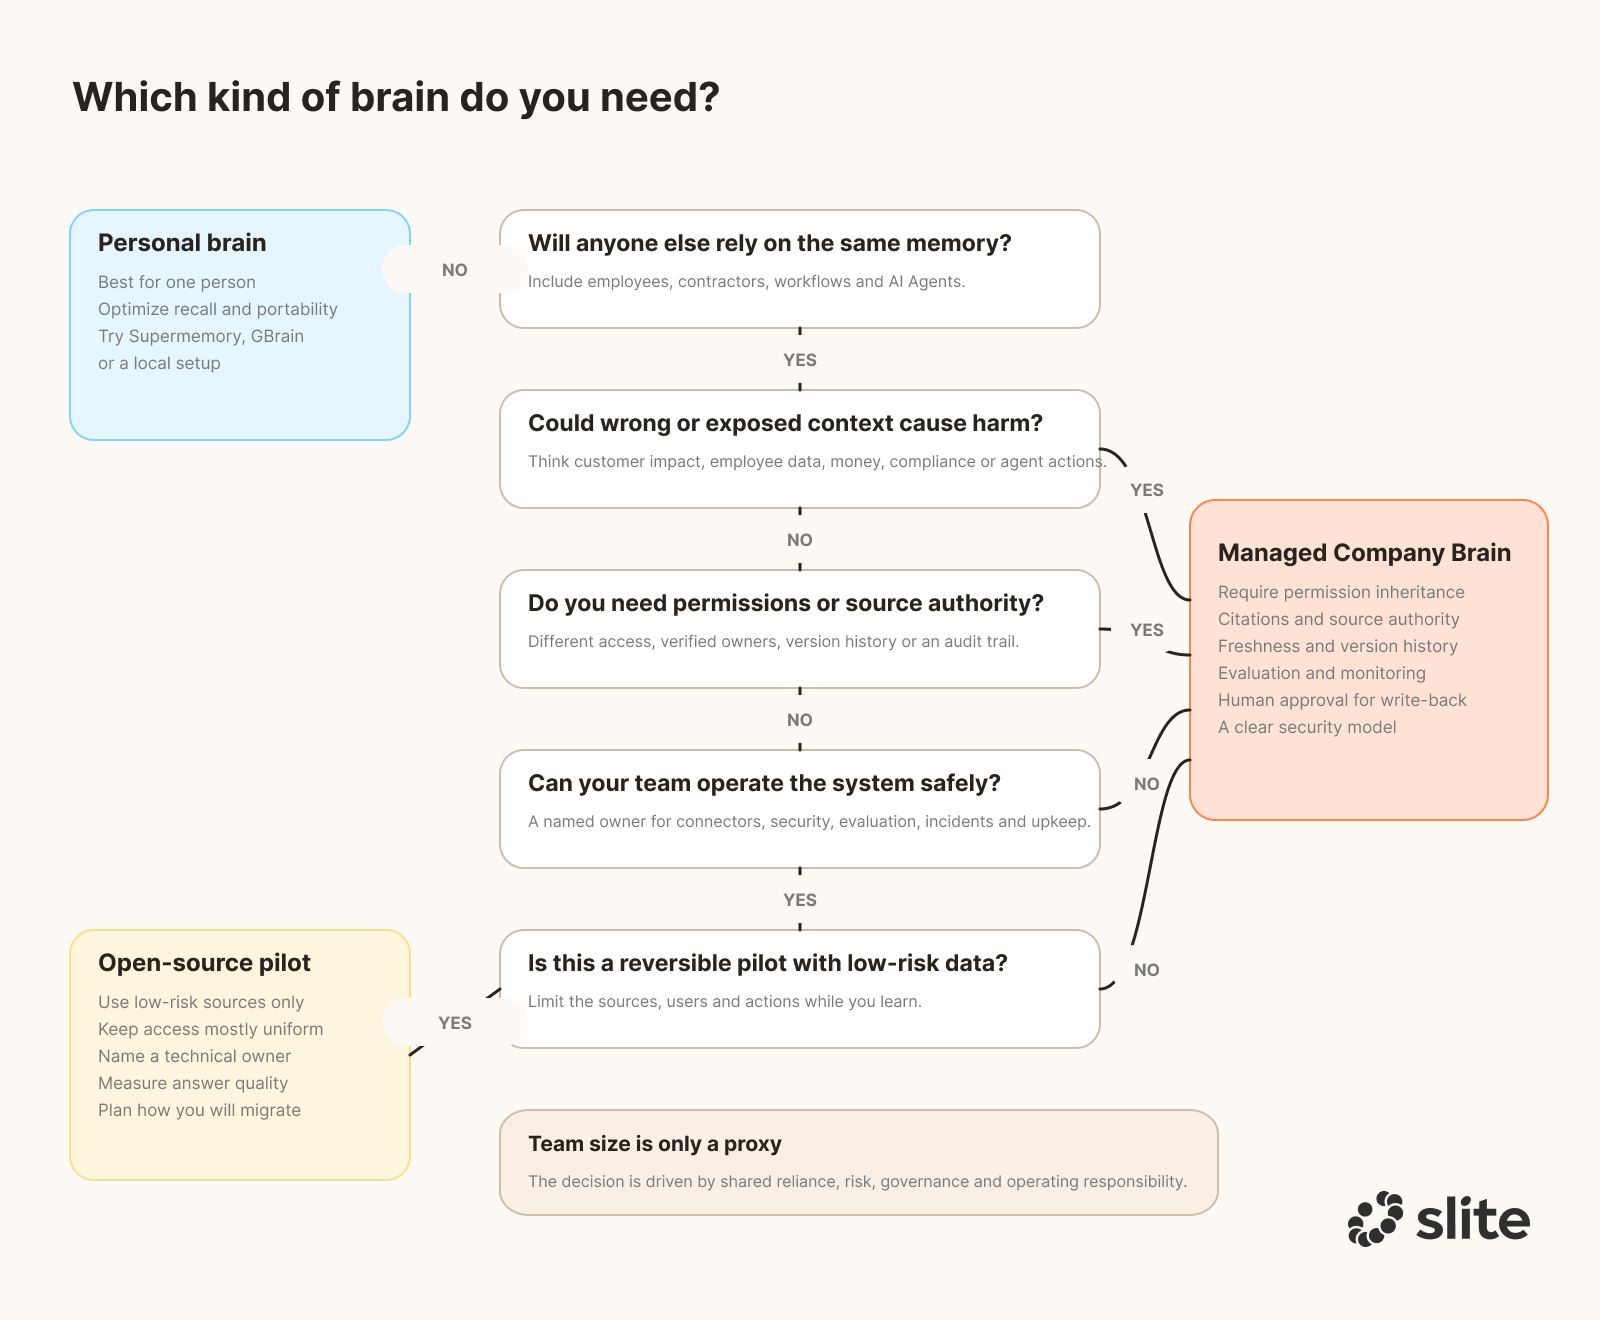
Elige un brain personal cuando la memoria es tuya
Si quieres conectar tus notas, lecturas, reuniones e ideas, empieza con una herramienta personal.
Supermemory, GBrain y otros proyectos de código abierto similares pueden ayudarte a construir memoria persistente sin introducir permisos ni gobernanza a nivel de empresa.
La pregunta principal es si el sistema encaja con la forma en que consumes y creas información.
Considera el código abierto para un equipo pequeño y unido
Un Company Brain de código abierto puede funcionar cuando tu equipo es pequeño, la mayoría de las personas puede acceder a la misma información y alguien técnico puede mantener el sistema.
Es un camino razonable para una startup de diez personas que opera como una sola unidad. Se vuelve menos cómodo cuando entran en el sistema datos de clientes, información de empleados o niveles de acceso diferentes.
El código abierto no elimina el trabajo de seguridad y mantenimiento. Lo transfiere a tu equipo.
Elige un company brain gestionado cuando el contexto se convierte en infraestructura
Un company brain dedicado, como Slite, es útil cuando distintas personas y agentes necesitan distintos accesos, las fuentes se contradicen o el conocimiento de la empresa debe mantenerse actualizado sin que un fundador lo mantenga.
También debería convertirse en la opción por defecto cuando el sistema maneja información sensible o suministra contexto a agentes que pueden ejecutar acciones.
Slite Agent está construido para este camino. Da a los equipos un lugar gobernado para mantener el conocimiento de la empresa y ponerlo a disposición tanto de empleados como de agentes.
Si buscas desplegar algo para tu equipo en crecimiento con estos fundamentos resueltos desde el primer día, reserva una demo para hablar con nosotros.