Un company brain toma todo lo que sabe tu empresa, lo que hay en documentos, en la cabeza de las personas y repartido entre herramientas, y lo hace utilizable como respuestas o como contexto. Tanto para personas como para agentes.
Si el término es nuevo para ti, empieza por nuestra definición completa y la historia de su origen y luego vuelve aquí.
La categoría tiene apenas seis meses y decenas de empresas quieren ahora que se las conozca como el company brain.
Algunas son repositorios de código abierto con unos cientos de estrellas. Otras son bibliotecas de memoria para desarrolladores. Otras son proyectos internos que nunca se pensaron para venderse. Y unas pocas son productos dedicados.
Todas responden al mismo encargo, pero lo hacen con formas muy distintas.
Mientras tanto, la mayoría de los equipos no tiene ninguno. Cuando encuestamos a 149 equipos en julio de 2026, solo el 17% dijo tener un company brain que funciona. Otro 27% intentó construir uno y lo dejó, casi siempre por el mantenimiento y no por la tecnología.
Así que, para nuestra investigación de Company Brain 101, probamos y analizamos una docena de productos que dicen ser soluciones de company brain, y entrevistamos a más de diez personas que los están construyendo ahora mismo.
Puntos clave
- Toda solución de company brain, de código abierto o comercial, se descompone en los mismos cuatro componentes: captar señales, recordar, soñar y podar, y hablar y buscar.
- El mercado se divide en cuatro familias: patrones autoalojados, SDK de memoria, actores establecidos integrados y company brains dedicados. Cada una reparte de forma distinta el esfuerzo humano de mantenimiento frente al coste de cómputo.
- El componente que separa un company brain que funciona de una wiki obsoleta es el mantenimiento. Solo un puñado de las herramientas que estudiamos lo automatiza, y todas mantienen a una persona en el circuito.
- Solo el 17% de los equipos que encuestamos tiene un company brain que funciona. La precisión (77%) y los permisos (63%) son las preocupaciones que deciden qué familia deberías elegir.
- Si tienes ingenieros con ganas y menos de 50 personas, autoaloja. Si estás construyendo tus propios agentes, usa un SDK de memoria. Para todos los demás, lo adecuado es un company brain dedicado que automatice el mantenimiento sin encerrar tu contexto en una sola plataforma.
Todo company brain tiene los mismos cuatro componentes
Miramos por dentro una docena de soluciones de company brain para nuestro ebook, de código abierto y comerciales, personales y para toda la empresa, construidas a medida y compradas. Se diferencian en casi todo.
Salvo en un punto. Todas están construidas con los mismos cuatro componentes. El cerebro capta señales, recuerda, sueña y poda, y habla cuando le hablan.
Captar señales
Captar señales es la forma en que el cerebro se entera de lo que ha pasado hoy en la empresa. Un flujo constante es lo que le permite describir tu empresa tal como es ahora, tanto si lo consulta una persona como si un agente extrae contexto de él.
Las herramientas y los sistemas de registro, como tu CRM, la gestión de proyectos, el chat y las herramientas de desarrollo, generan actividad a distintas velocidades y en distintos volúmenes, así que los métodos de captura equilibran frescura frente a coste y ruido.
Cuatro enfoques cubren el terreno:
- Extracciones programadas. Un conector sincroniza cada herramienta a intervalos fijos. Útil para fuentes de cambio lento, como documentos y registros del CRM.
- Captura de eventos. Un webhook envía cada evento al cerebro en el momento en que ocurre. Útil para fuentes de cambio rápido, como el chat y los tickets.
- Ingesta por agente. Un agente lee una fuente, se queda con lo que importa y escribe un resumen estructurado en el cerebro. Útil para fuentes con mucho ruido, como las transcripciones de reuniones.
- Recuperación en el momento de la consulta. No se almacena nada. El cerebro consulta las fuentes en vivo en cuanto llega una pregunta. Útil cuando el sistema de origen debe seguir siendo la única copia.
Recordar
Recordar es la forma en que el cerebro almacena el conocimiento para poder encontrarlo de nuevo. Esa forma decide qué preguntas podrá responder el cerebro más adelante.
Las formas más ricas responden más, pero cuestan más de construir y mantener, y por eso conviven cuatro:
- Archivos de texto plano. Markdown en un repositorio git, legible por cualquier persona y cualquier agente. Útil para equipos técnicos pequeños que no quieren infraestructura.
- Documentos. Una base de conocimiento con responsables y permisos. Útil cuando las personas son las lectoras principales.
- Índice vectorial. Todo se convierte en embeddings y se busca por significado en lugar de por palabras clave. Útil para grandes montones de contenido no estructurado.
- Grafo de conocimiento. Entidades y relaciones almacenadas como aristas tipadas, en las versiones más ricas con una ventana de validez para cada dato. Útil cuando las preguntas implican relaciones o historia.
Algunos cerebros combinan dos de estas formas a propósito: documentos legibles para las personas más un nivel estructurado y denso que solo abren los agentes.
Soñar y podar
Soñar y podar es la forma en que el cerebro mantiene actualizado por sí mismo el conocimiento de la empresa sin que nadie se lo pida.
- "Soñar" se toma prestado del ciclo de sueño nocturno de GBrain: una tarea programada en la que el cerebro relee lo que aprendió ese día, lo reorganiza y lo vuelve a enlazar, igual que el sueño consolida la memoria.
- Podar es la otra mitad: retirar lo que ya no se sostiene.
El contexto de la empresa se queda obsoleto de maneras distintas:
- por antigüedad,
- por desuso,
- o por contradicción con lo que realmente ocurre en tus herramientas.
Cada una necesita su propia rutina:
- Ejecuciones de consolidación. Una tarea programada reorganiza y vuelve a enlazar todo lo que entró ese día. Útil para mantener coherente la memoria a medida que crece.
- Caducidad por tiempo. Los datos antiguos y sin uso pierden peso en la recuperación, o caducan del todo. Útil contra el envejecimiento silencioso.
- Detección de desviaciones. El cerebro compara lo que afirman los documentos con la actividad real de las herramientas conectadas y señala las discrepancias. Útil para detectar páginas que la realidad ha dejado atrás.
- Colas de revisión. Cada cambio que propone el cerebro espera en una bandeja a que una persona lo apruebe. Útil allí donde una actualización errónea cuesta más que una lenta.
Hablar y buscar
Hablar y buscar es donde todo se une: el lugar donde la gente busca de verdad y el lugar del que los agentes extraen contexto. Cada tipo de interlocutor necesita su propia puerta. Las personas quieren una conversación. Las máquinas quieren un endpoint.
- Chat. Preguntas en lenguaje natural, respuestas con citas que remiten a las fuentes. Útil para las preguntas cotidianas del equipo.
- Búsqueda híbrida. Buscar por significado y por palabra clave exacta a la vez, y luego reordenar los resultados. Útil como maquinaria subyacente a todos los demás modos.
- API headless o MCP. El cerebro expuesto como un endpoint que otros sistemas consultan directamente. Útil para conectar el cerebro con agentes de programación, bots de soporte y flujos de trabajo.
- Aplicaciones dedicadas. Interfaces hechas a medida para un equipo o un flujo de trabajo concreto. Útil cuando un caso de uso merece su propia superficie.
Ninguna solución ejecuta todo esto a la vez. Cada una elige una única opción por componente, y esas elecciones son lo que hace que dos company brains se comporten de forma completamente distinta.
| Captar señales | Recordar | Soñar y podar | Hablar y buscar |
|---|---|---|---|
| Extracciones programadas con conectores | Markdown plano en un repositorio git | Ejecuciones nocturnas de consolidación | Chat con citas |
| Webhooks y captura de eventos | Documentos de wiki o de base de conocimiento | Caducidad por tiempo y vencimiento de datos | Búsqueda híbrida |
| Ingesta ejecutada por agentes que estructura las fuentes | Índice vectorial sobre todo | Detección de desviaciones frente a herramientas en vivo | API headless / MCP hacia otras herramientas |
| Recuperación en el momento de la pregunta, sin almacenar nada | Grafo de contexto ontológico o temporal | Cola de revisión humana para cada cambio | Interfaces de aplicaciones dedicadas |
Las cuatro familias de soluciones de company brain
Cada solución del mercado hace un equilibrio distinto entre las cinco preocupaciones que nuestros encuestados nombraron más: la precisión (77%), la privacidad y los permisos (63%), la carga de mantenimiento (58%), el coste de la ingesta y el mantenimiento diarios (58%) y el esfuerzo de puesta en marcha (33%). La forma más clara de ver ese equilibrio es comparar costes: lo que pagas en mantenimiento humano frente a lo que pagas en cómputo y suscripciones.
Representado así, el mercado se divide en cuatro familias.
| Familia | A quién sirve | Qué ofrece | Qué te cuesta |
|---|---|---|---|
| Patrones autoalojados (GBrain, Sylph, construcción propia) | Equipos técnicos que quieren soberanía total | Código abierto, archivos planos, coste de ejecución casi nulo, portabilidad total | El mantenimiento recae por completo en tus personas. Es la historia de ese 27%. |
| SDK de memoria (mem0, Letta, Zep) | Ingenieros que construyen sus propios agentes | Bloques de construcción de núcleo abierto, extracción automática, grafos temporales | Tú ensamblas y ajustas todo lo que hay por encima de la capa de memoria |
| Actores establecidos integrados (Notion AI, Rovo, Slack AI, Glean, ChatGPT y Claude Enterprise) | Organizaciones que ya viven dentro de una suite | Menor esfuerzo de puesta en marcha, con permisos integrados de serie | Bloqueo de contexto: tu cerebro pertenece a la plataforma |
| Company brains dedicados (Slite Agent, Carrara, Pletor) | Equipos que quieren la capa independiente de modelos y plataformas | Mantenimiento automatizado con revisión humana, portabilidad como característica | Una suscripción, y confías en un proveedor para toda la capa |
La mayoría de los equipos ya tiene alguna versión de la tercera familia. Todas las grandes plataformas están construyendo un cerebro sobre la porción de contexto que ya poseen:
- Salesforce con Slack AI,
- Atlassian con Rovo,
- Notion con Notion AI,
- Microsoft y Google dentro de sus suites,
- OpenAI y Anthropic desde el lado de los modelos.
Son las más rápidas de activar. El problema es lo que llamamos bloqueo de contexto.
Un company brain tiene que leer a través de todas las fuentes, lo que significa que quien lo gestiona tiene la versión más completa y portable de tu empresa que ha existido nunca en un solo lugar.
Cuando esa capa pertenece a una plataforma de la que no puedes salir, pagas el bloqueo en cada respuesta, en cada agente y en cada flujo de trabajo construido encima.
La presión ya se nota: desde mediados de 2025, las herramientas de terceros ya no pueden indexar en bloque los mensajes de Slack, y las aplicaciones que no están en el Marketplace tienen límites de peticiones y no pueden conservar datos históricos.
El mismo equilibrio aparece en muchas herramientas nativas de suites, y por eso los equipos empiezan a buscar alternativas cuando el bloqueo se vuelve caro.
10 soluciones de company brain y qué utiliza realmente cada una
Para cada herramienta: qué es, para quién es y sus cuatro elecciones de componentes, tomadas de la documentación pública y, cuando pudimos conseguirlas, de entrevistas con las personas que la construyen. Las entradas están agrupadas por familia, sin un orden de preferencia concreto.
Patrones autoalojados
1. Construcción propia: Claude Code + un repositorio git
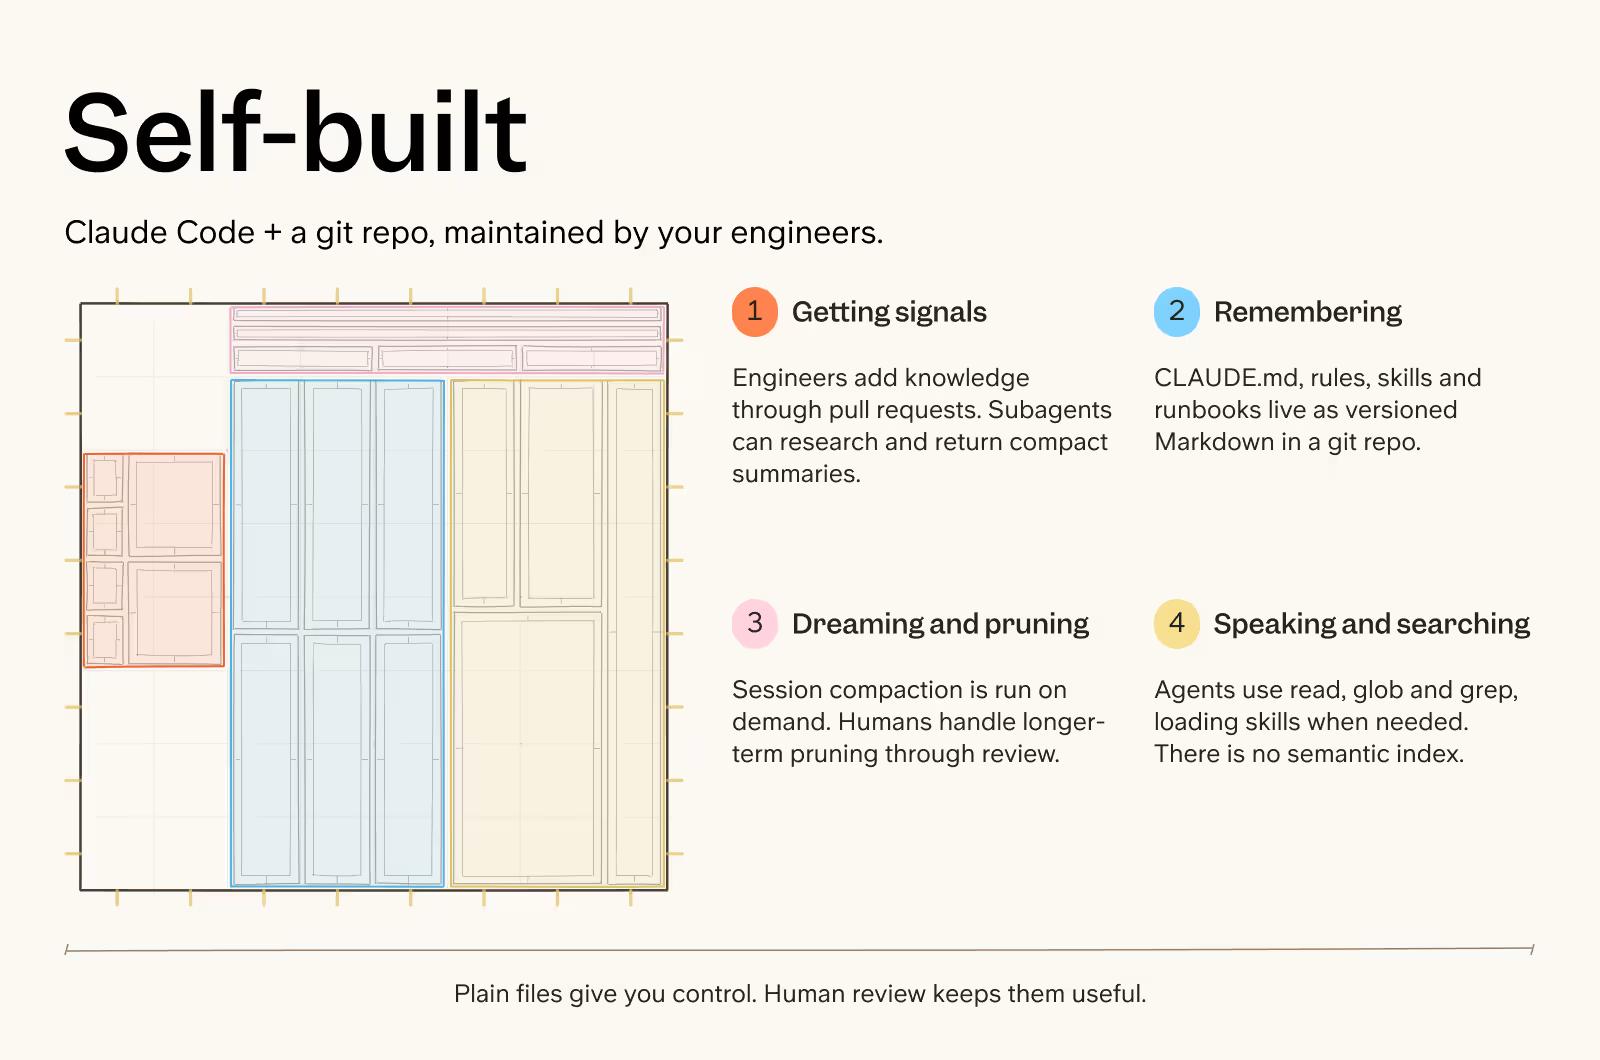
El patrón con el que empezó la mitad de nuestros encuestados que probaron un company brain: un agente de programación conectado a un repositorio de Markdown, pull requests y búsqueda en archivos planos. Sin producto, sin proveedor y con un ingeniero que lo mantiene sano.
| Componente | Qué utiliza |
|---|---|
| Captar señales | Los ingenieros añaden y actualizan el conocimiento mediante pull requests. Los subagentes pueden investigar en paralelo y devolver resúmenes compactos para que el agente principal los guarde. |
| Recordar | La memoria vive en el repositorio git: CLAUDE.md, reglas, skills, runbooks y otros archivos Markdown, todos versionados junto con el resto del sistema. |
| Soñar y podar | La compactación de sesión es un comando que ejecutas cuando el contexto se satura. La poda a más largo plazo se hace mediante revisión humana, normalmente en pull requests. |
| Hablar y buscar | Los agentes usan read, glob y grep para encontrar contexto en archivos planos, y cargan las skills solo cuando hacen falta. No hay índice semántico. |
Coste y encaje. Gratis, salvo el uso de modelos. Ideal para equipos liderados por ingeniería de menos de 50 personas que quieren control total y no les importa que la curación sea una tarea permanente. Para ver los flujos de trabajo que esto desbloquea, consulta por qué Claude Code necesita un company brain.
2. GBrain
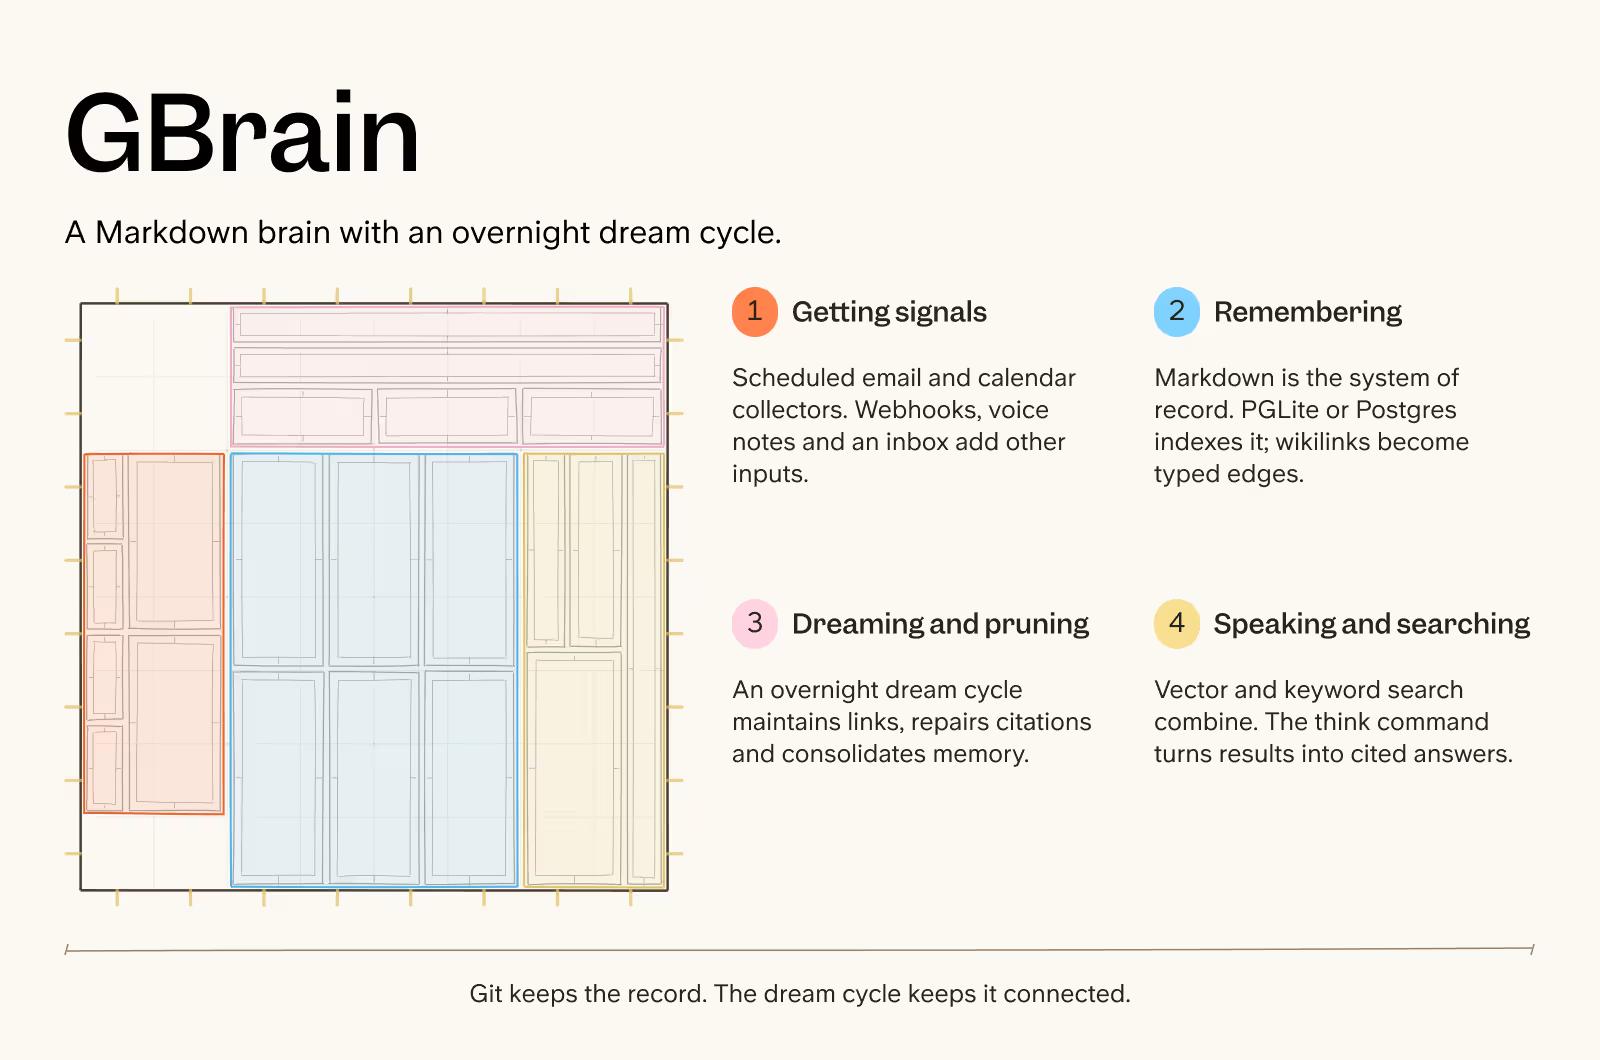
GBrain es el cerebro personal de código abierto que Garry Tan publicó en abril de 2026, y el proyecto que convirtió la Request for Startups de YC en una categoría. Git conserva el registro duradero. Un ciclo de sueño programado mantiene el grafo y consolida la memoria durante la noche.
| Componente | Qué utiliza |
|---|---|
| Captar señales | El correo y el calendario entran a través de recolectores programados. Los webhooks generales, las notas de voz, una carpeta de entrada y los skillpacks personalizados te dan otras formas de alimentar el cerebro. |
| Recordar | Tu repositorio de Markdown sigue siendo el sistema de registro. GBrain lo indexa con PGLite por defecto, o con Postgres y pgvector para despliegues compartidos, y convierte los wikilinks locales en aristas tipadas sin necesidad de un LLM. |
| Soñar y podar | Programa el ciclo de sueño por la noche y GBrain mantiene los enlaces, repara las citas y consolida la memoria. Su comando "think" también señala contexto obsoleto, afirmaciones sin cita y contradicciones. |
| Hablar y buscar | La búsqueda combina recuperación vectorial y por palabras clave con fusión de rangos. Tres modos de búsqueda equilibran coste y calidad, y "think" convierte los resultados en una respuesta con citas. |
Coste y encaje. Gratis de ejecutar, más allá de tus propios costes de embeddings y de modelo. Está pensado primero para el contexto de una sola persona; funciona como company brain para un equipo técnico pequeño que se maneje con soltura en una terminal. Si estás buscando alternativas a GBrain, las más cercanas son Sylph, más abajo, para un repositorio compartido, y mem0 o Zep para una capa de memoria bajo tus propios agentes. Lo analizamos en profundidad en GBrain, análisis.
3. Sylph
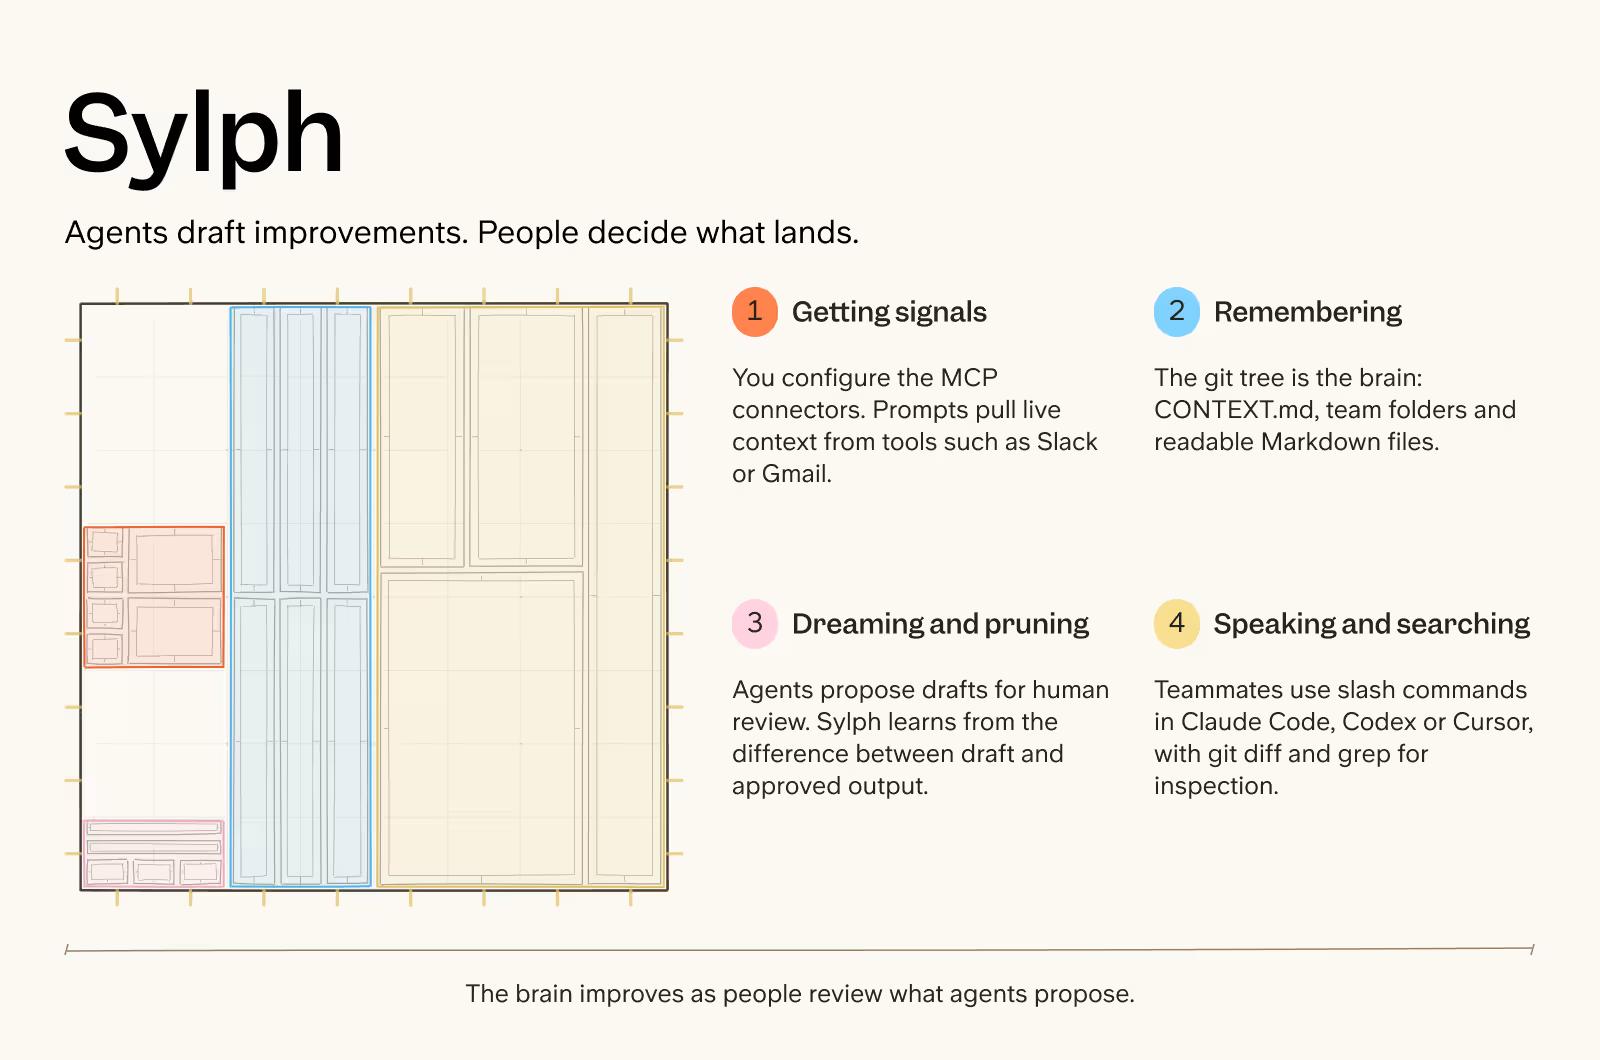
Sylph, de nao Labs, mantiene el company brain en un repositorio git que puedes leer y moldear tú mismo. Los agentes pueden redactar mejoras, pero las personas deciden qué se incorpora.
| Componente | Qué utiliza |
|---|---|
| Captar señales | Sylph no incluye fuentes de datos externas. Tú eliges y configuras los conectores MCP que puede usar, de modo que los prompts pueden extraer contexto en vivo de herramientas como Slack o Gmail. |
| Recordar | El cerebro es el propio árbol de git: un CONTEXT.md central, carpetas por dominio para equipos como marca, ventas, producto, RR. HH. y legal, y archivos Markdown que los agentes pueden leer. |
| Soñar y podar | Los agentes colocan las mejoras propuestas en una carpeta de borradores para su revisión humana. Cuando alguien aprueba un resultado, Sylph compara el borrador con lo que se conservó y actualiza sus propias reglas a partir de la diferencia. |
| Hablar y buscar | Los compañeros trabajan mediante comandos con barra en Claude Code, Codex o Cursor. Como la memoria es Markdown plano en git, las personas pueden inspeccionar los cambios con herramientas conocidas como git diff y grep. |
Coste y encaje. Gratis y de código abierto. Un equipo del tamaño de una startup que ya gestiona sus operaciones con agentes de programación se sentirá como en casa. La contrapartida es que nada está automatizado: el cerebro mejora solo a la velocidad a la que una persona revisa los borradores.
SDK de memoria
4. mem0
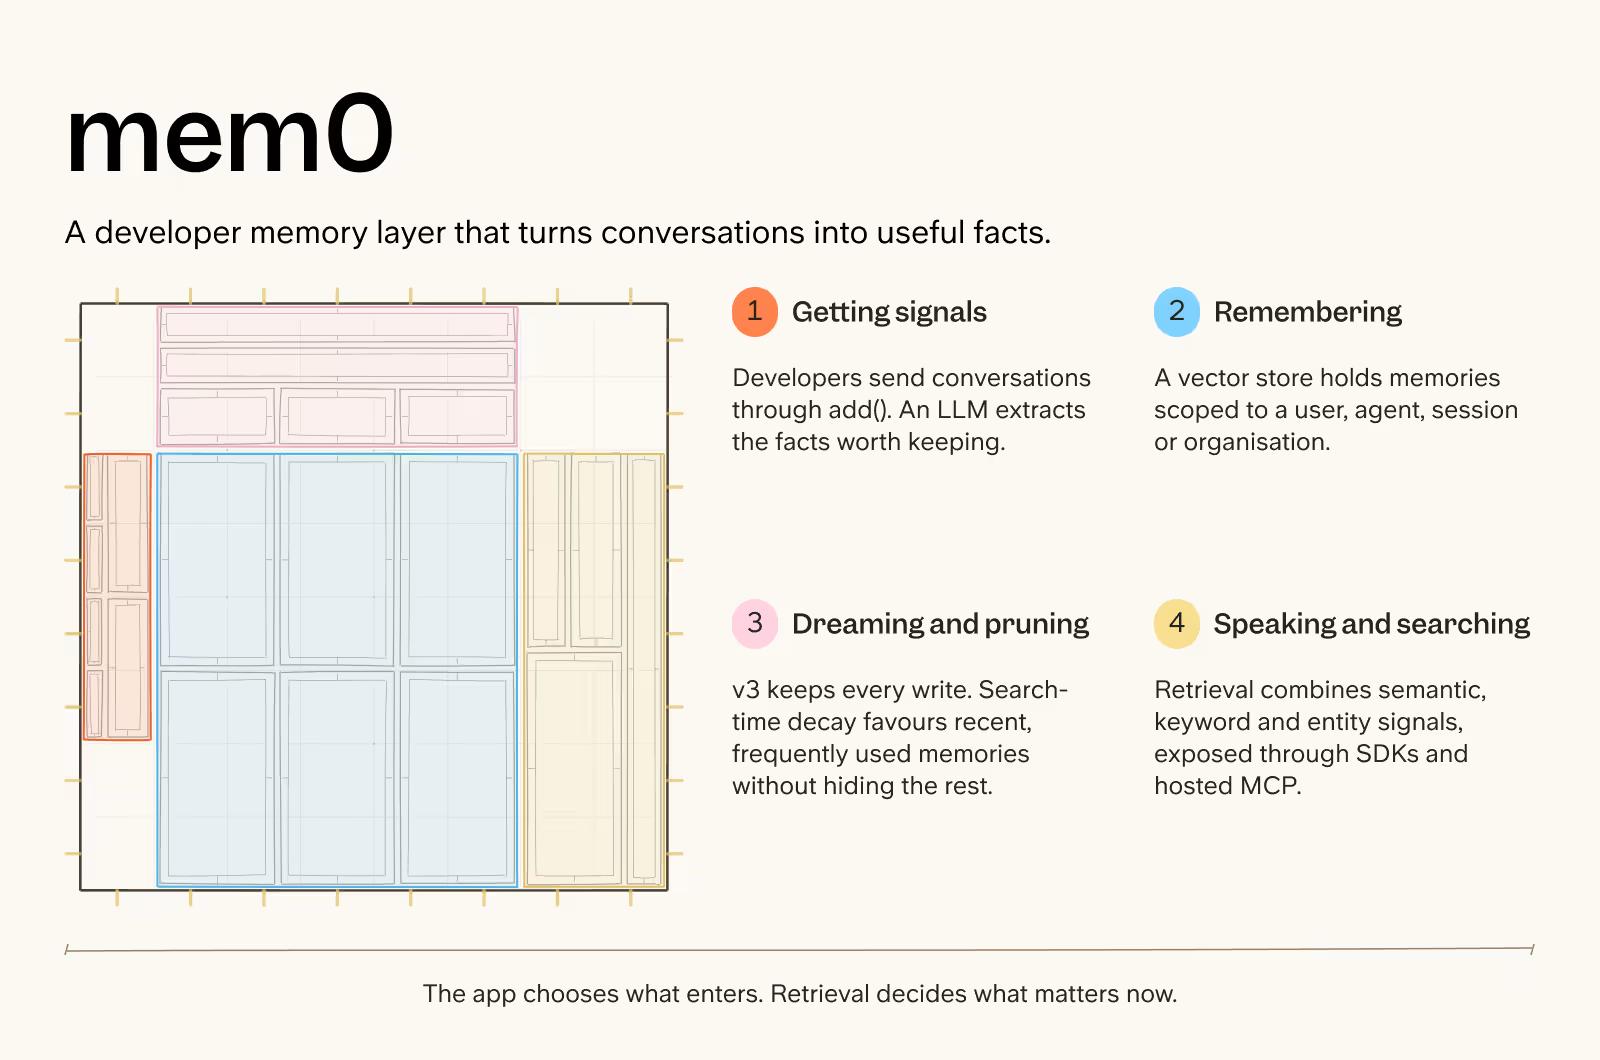
mem0 es una capa de memoria para desarrolladores que convierte las conversaciones en datos útiles y devuelve los adecuados cuando una aplicación los necesita. Es la opción más extendida de esta familia, con una plataforma alojada sobre el núcleo de código abierto.
| Componente | Qué utiliza |
|---|---|
| Captar señales | Los desarrolladores deciden cuándo enviar una conversación mediante una llamada add(). mem0 usa un LLM para extraer los datos que merece la pena conservar, así que la ingesta empieza dentro de la aplicación y no según un calendario. |
| Recordar | Los recuerdos viven en un almacén vectorial y se pueden acotar a un usuario, agente, sesión u organización. La extracción de entidades viene incluida en el código abierto, mientras que el grafo interactivo está en la plataforma alojada. |
| Soñar y podar | v3 conserva cada escritura en lugar de actualizar o borrar recuerdos antiguos. En el momento de la búsqueda, la caducidad de memoria favorece con suavidad los recuerdos recientes y de uso frecuente sin ocultar el resto. |
| Hablar y buscar | Cuando la aplicación pide contexto, mem0 combina la búsqueda semántica con señales de palabras clave y de entidades. Los desarrolladores pueden usar sus SDK o conectarse mediante el servidor MCP alojado. |
Coste y encaje. El código abierto es gratuito. La plataforma alojada tiene un plan gratuito y planes de pago por uso. Elígelo si estás construyendo tus propios agentes y quieres una memoria que funcione sin complicaciones, y asume que tú ensamblas todo lo que hay por encima de la capa de memoria.
5. Zep / Graphiti
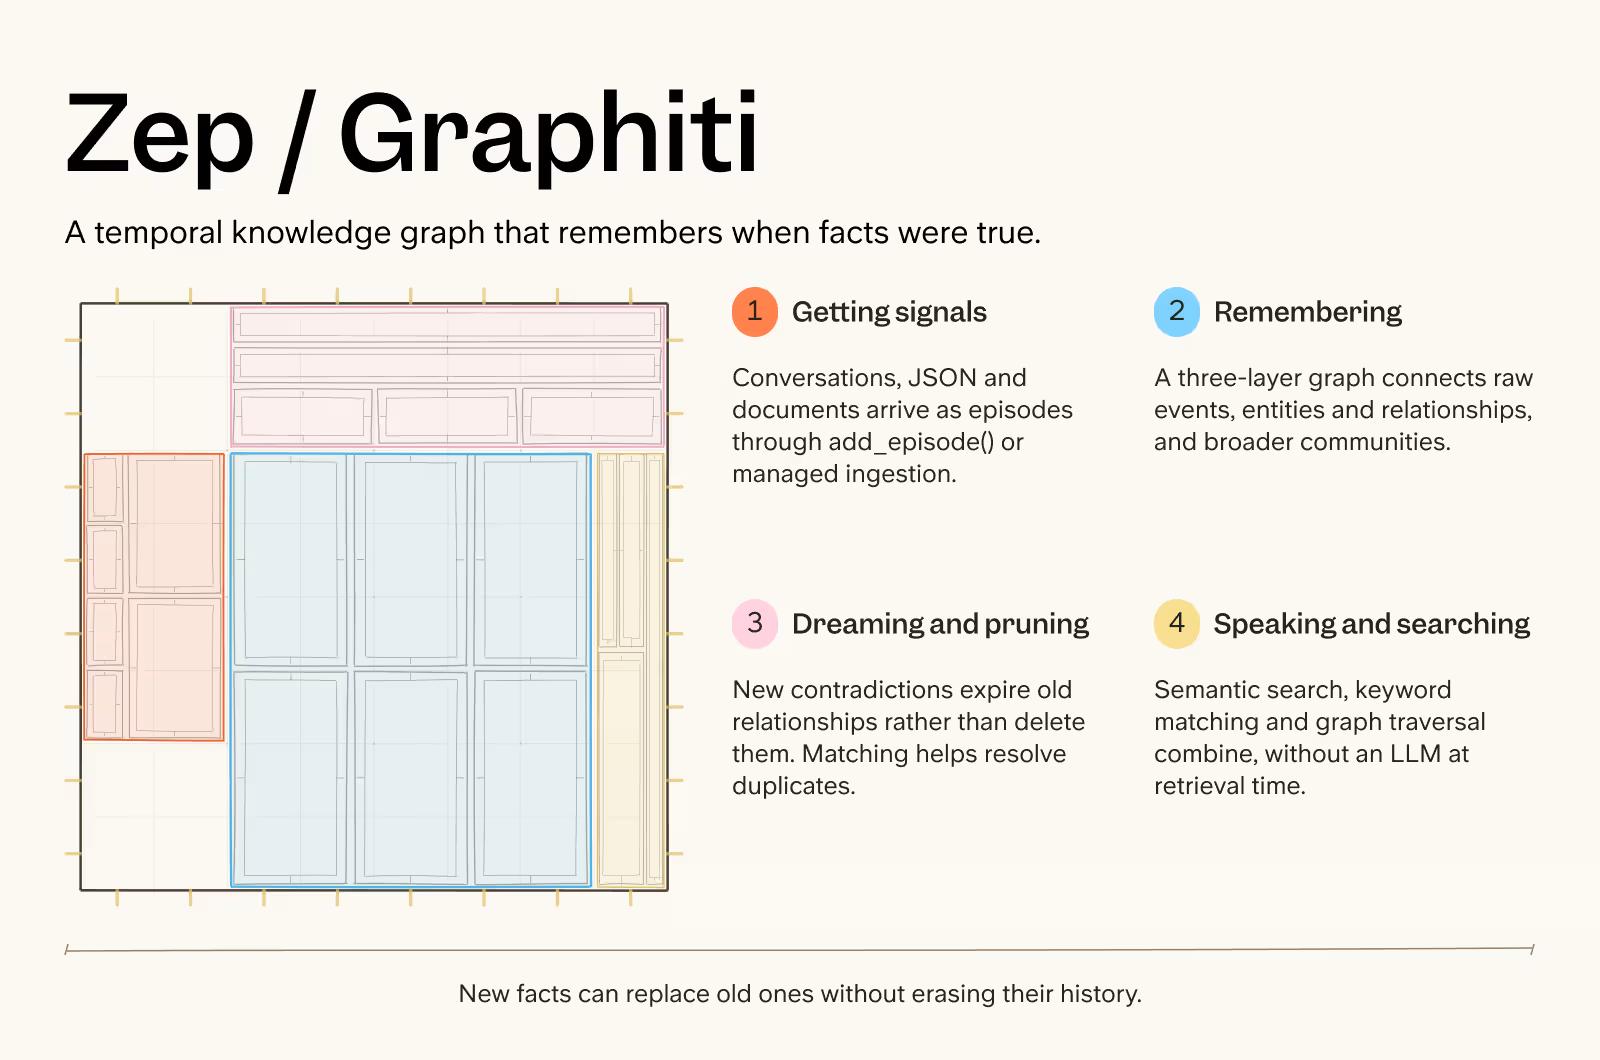
Zep mantiene un grafo temporal de personas, eventos y datos, y marca la información antigua como caducada cuando algo más reciente la deja obsoleta. Graphiti es el motor de grafos de código abierto que hay debajo.
| Componente | Qué utiliza |
|---|---|
| Captar señales | Las conversaciones, el JSON y los documentos llegan como episodios mediante una llamada add_episode() o la canalización de ingesta gestionada de Zep. |
| Recordar | Cada episodio alimenta un grafo de conocimiento de tres capas: eventos en bruto, entidades y relaciones extraídas, y comunidades más amplias. Los datos se convierten en embeddings y llevan marca de tiempo, así que el grafo recuerda tanto lo que ocurrió como cuándo era cierto. |
| Soñar y podar | Cuando información nueva contradice un dato anterior, un LLM marca la relación antigua como caducada en lugar de borrarla. La coincidencia aproximada controlada por entropía ayuda a resolver duplicados probables sin fusionar nombres ambiguos. |
| Hablar y buscar | En el momento de la consulta, Zep combina búsqueda semántica, coincidencia de palabras clave y recorrido del grafo. Como la recuperación no necesita un LLM, los resultados llegan en bastante menos de un segundo. |
Coste y encaje. Graphiti es gratuito. La nube de Zep es freemium con planes enterprise. Es la elección adecuada cuando tus preguntas implican historia ("¿qué era cierto en marzo?") y tienes ingenieros para ajustar la recuperación.
6. Letta
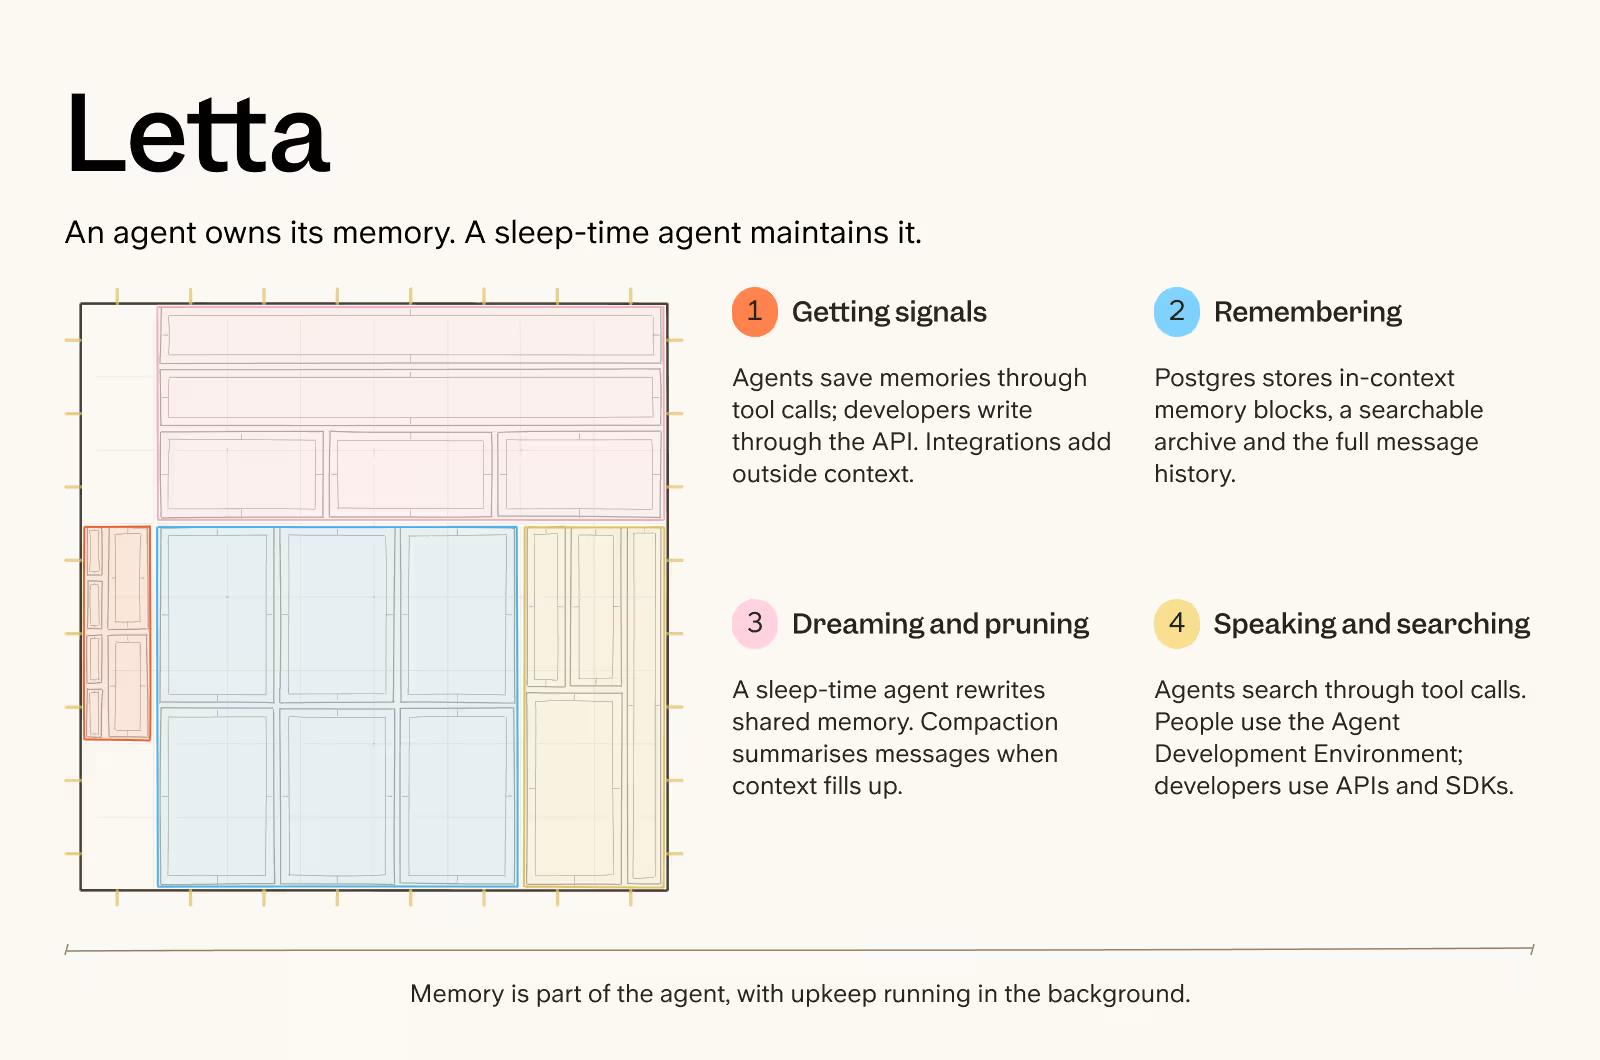
Letta deja que sea el agente quien decida qué merece estar en la memoria, mientras un agente de tiempo de sueño trabaja en segundo plano sobre el contexto compartido. Nació del artículo de investigación de MemGPT y es la opción con más base académica de esta lista.
| Componente | Qué utiliza |
|---|---|
| Captar señales | El agente puede guardar y actualizar recuerdos mediante sus propias llamadas a herramientas, mientras que los desarrolladores pueden escribir a través de la API. Las integraciones nativas con Slack, Telegram y GitHub pueden aportar contexto externo. |
| Recordar | La memoria se divide en tres capas: pequeños bloques etiquetados que se mantienen en contexto, un archivo con capacidad de búsqueda fuera de la ventana de contexto y el historial completo de mensajes. Letta los almacena en Postgres. |
| Soñar y podar | Un agente de tiempo de sueño reescribe la memoria compartida en segundo plano. Cuando el contexto se llena, la compactación resume aproximadamente el 30% de los mensajes y conserva el resto. |
| Hablar y buscar | El agente busca y actualiza la memoria mediante llamadas a herramientas. Las personas pueden inspeccionarla y editarla en el Agent Development Environment, mientras que los desarrolladores trabajan con APIs REST y SDK. |
Coste y encaje. El código abierto es gratuito; Letta Cloud se cobra por uso. Lo mejor para equipos que lanzan agentes con estado y quieren que sea el agente, y no una canalización, quien se encargue de su memoria.
Cerebros verticales e internos
7. Pletor
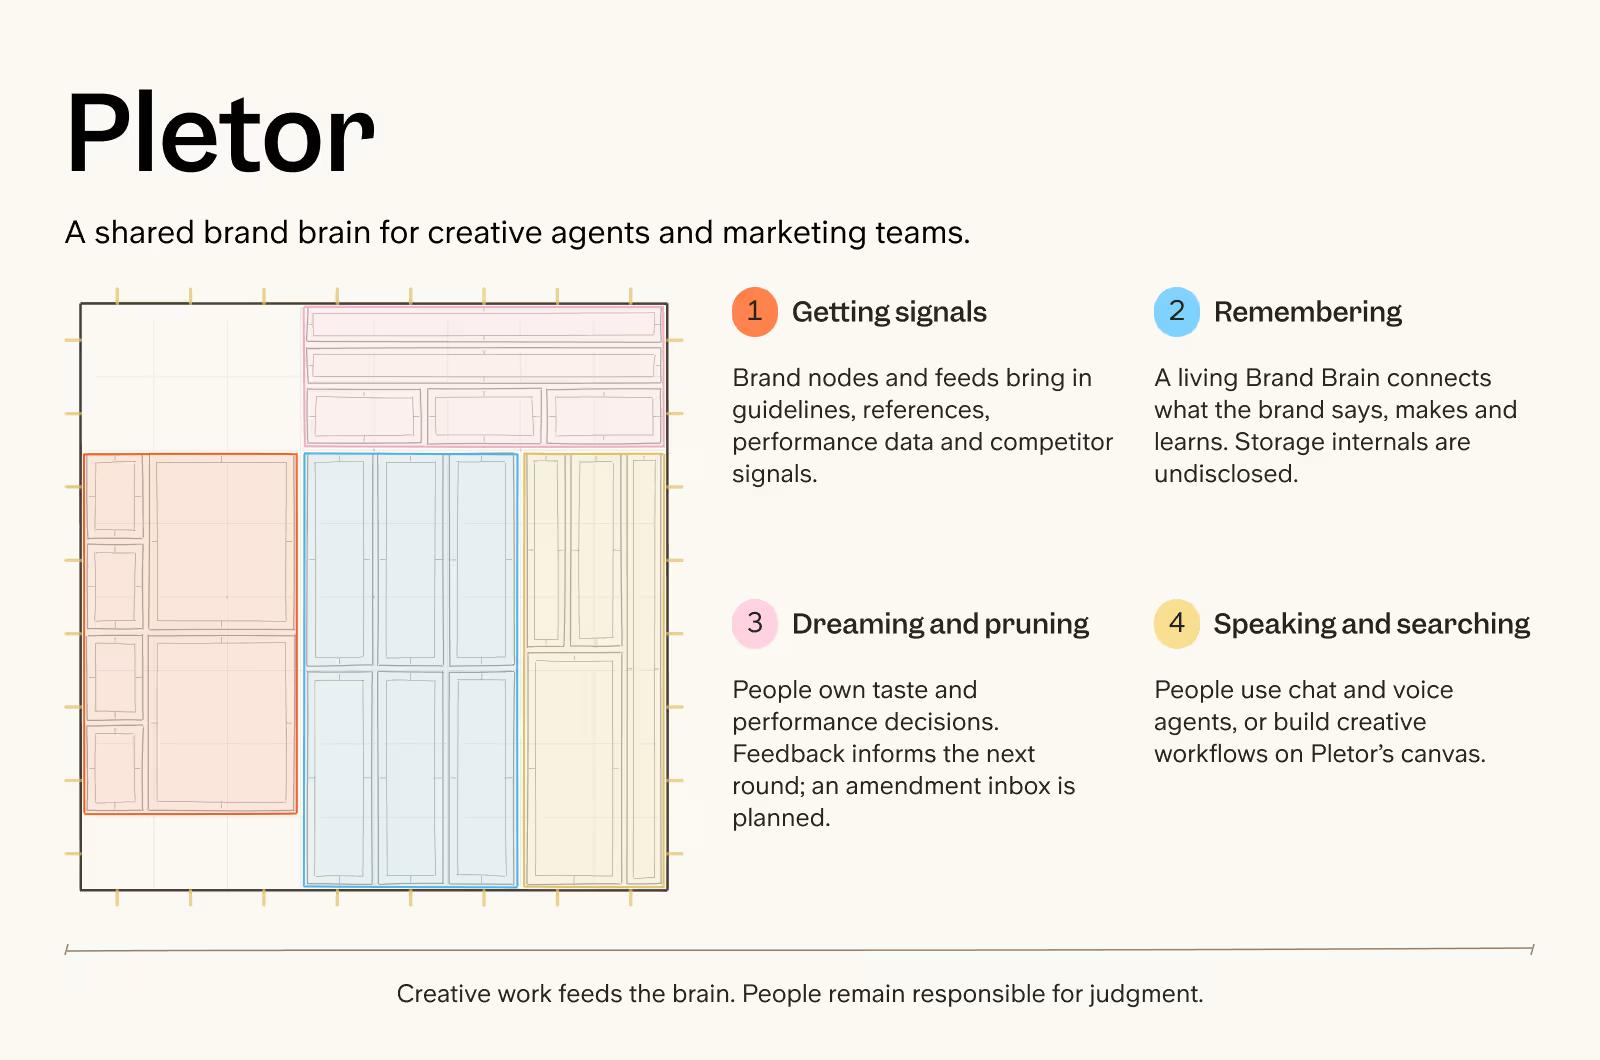
Pletor convierte las reglas de marca, las referencias creativas y los datos de rendimiento en una memoria compartida que sus agentes creativos pueden usar. Es un cerebro de marca para equipos de marketing y no un cerebro de toda la empresa, y está en esta lista porque muestra cómo es el patrón cuando se acota a una sola función.
| Componente | Qué utiliza |
|---|---|
| Captar señales | Los nodos de marca y los flujos de datos aportan pautas, referencias, datos de rendimiento y señales de la competencia. El sistema funciona con texto, imágenes, vídeo y audio. |
| Recordar | Pletor guarda esas entradas en un único Brand Brain vivo, que conecta lo que la marca dice, lo que hace y lo que aprende del rendimiento. Los detalles internos del almacenamiento no se han hecho públicos. |
| Soñar y podar | Las personas siguen siendo responsables de las decisiones de gusto y de rendimiento, mientras que el feedback y los resultados alimentan la siguiente ronda de trabajo creativo. Una bandeja para enmiendas al cerebro, deducidas de tus chats, está en la hoja de ruta. |
| Hablar y buscar | Las personas trabajan con el cerebro mediante chat y agentes de voz, o construyen flujos de trabajo creativos en el lienzo de Pletor. |
Coste y encaje. Freemium con planes de pago para equipos. Encaja con equipos de marketing que quieren que sus agentes respeten la marca por defecto. Sus fundadores fueron además las personas más sinceras que entrevistamos sobre los límites de la autonomía: "La promesa de tener un Claude abierto que aprende de tu Slack y simplemente ejecuta cosas es seductora. Pero es bastante difícil de llevar a cabo."
8. Gorgias Cortex
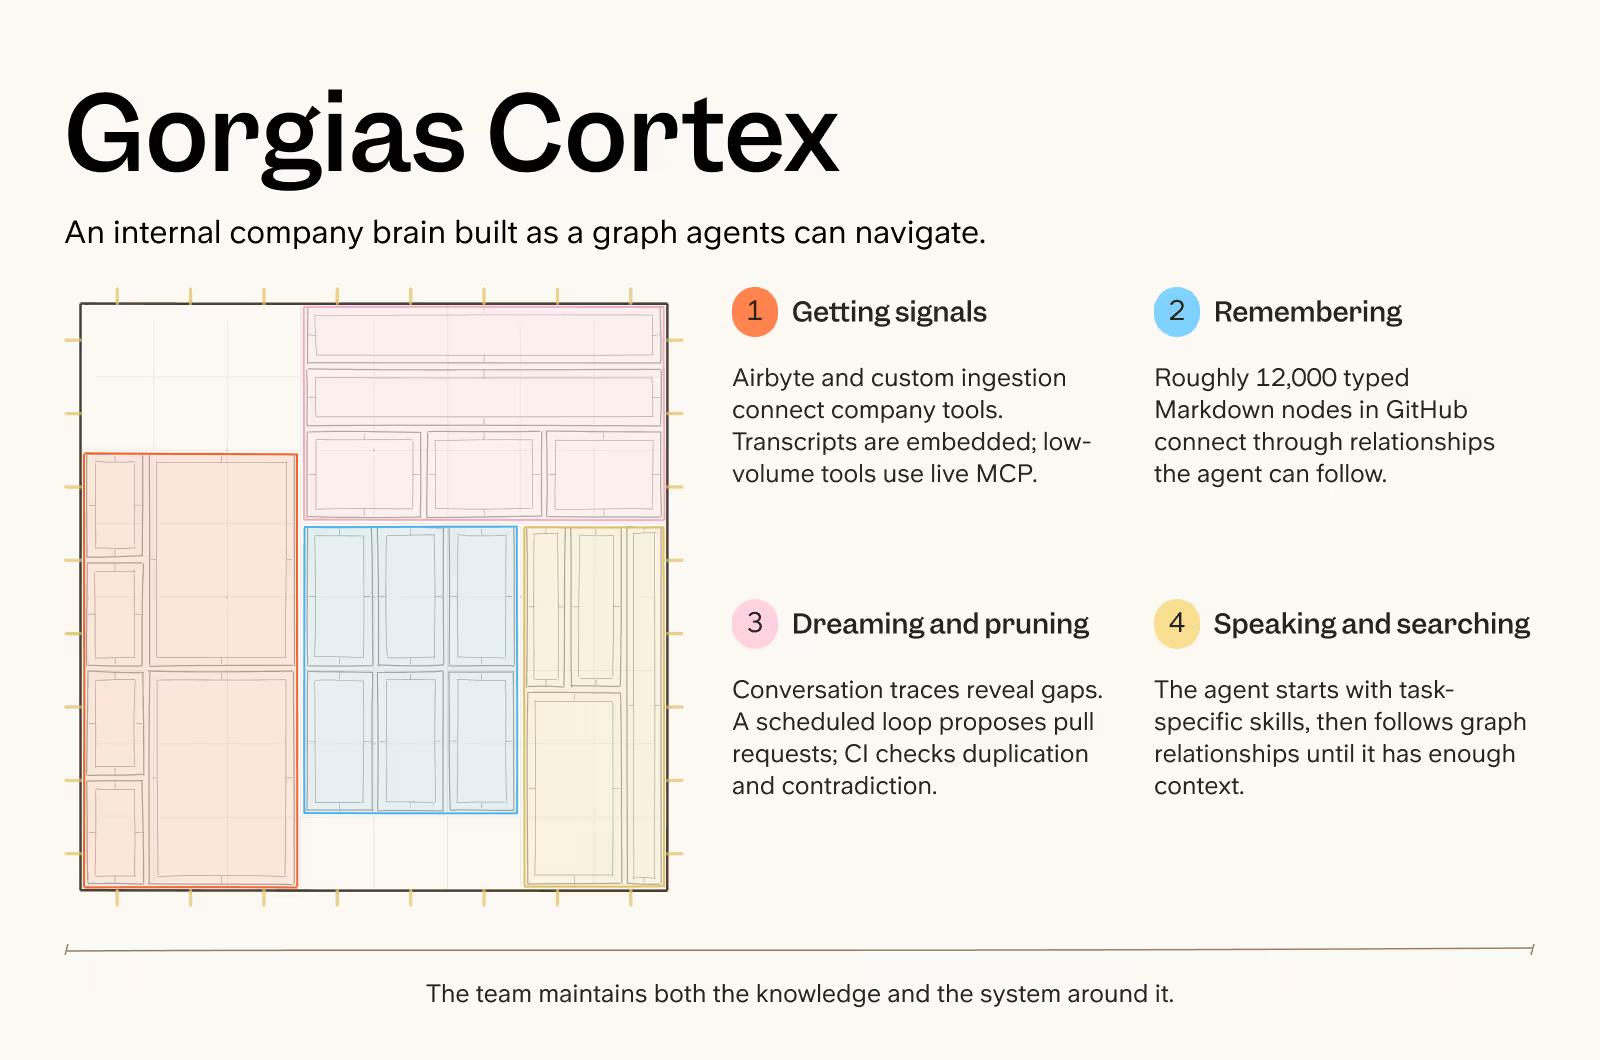
Gorgias construyó Cortex a partir de los sistemas que sus equipos ya usan, y convirtió el conocimiento de la empresa en un grafo por el que sus agentes pueden navegar. Es un proyecto interno, no un producto, y el company brain de construcción propia más completo que estudiamos.
| Componente | Qué utiliza |
|---|---|
| Captar señales | Airbyte y una herramienta de ingesta propia traen datos de Postgres, Notion, Gong, GitHub, Linear y HubSpot. Las transcripciones largas se dividen en fragmentos y se convierten en embeddings para que sigan siendo localizables; las herramientas de poco volumen se consultan en vivo mediante MCP. |
| Recordar | El resultado es un grafo de conocimiento de unos 12.000 nodos Markdown tipados en GitHub, conectados por relaciones que el agente puede seguir. |
| Soñar y podar | El equipo estudia las trazas de conversación para detectar contexto que falta. Un bucle de mantenimiento programado agrupa los vacíos recurrentes en pull requests que mejoran el grafo, y las comprobaciones de CI detectan duplicados y contradicciones antes de la fusión. |
| Hablar y buscar | El agente empieza con skills específicas de la tarea y luego sigue las relaciones por el grafo hasta tener contexto suficiente para responder. Una consulta típica cuesta entre 10 y 30 céntimos. |
Coste y encaje. No está a la venta, y esa es la lección. Gorgias puede permitirse los dos trabajos que exige un cerebro de construcción propia, curar el contenido y rediseñar el sistema a medida que el sector se mueve, porque tiene un equipo interno de IA de ocho personas. La mayoría de las empresas no.
Company brains dedicados
9. Carrara
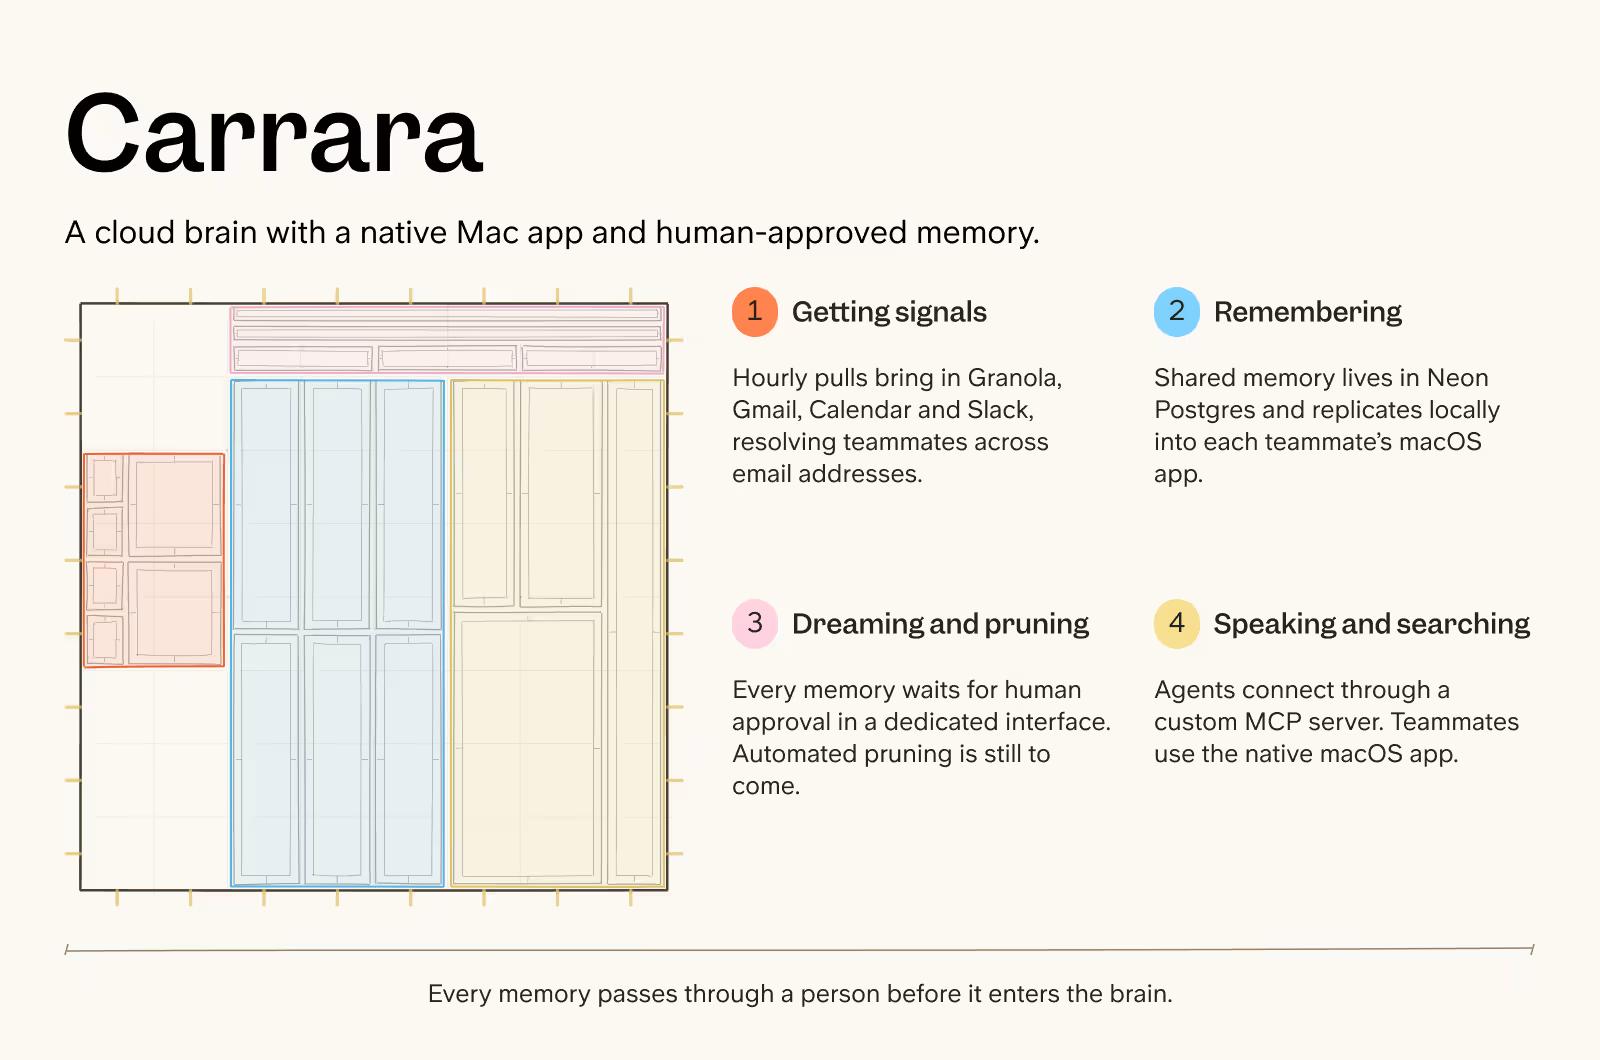
Carrara es un cerebro en la nube replicado en una aplicación nativa para Mac, en el que cada recuerdo lo aprueba una persona antes de entrar en el cerebro.
| Componente | Qué utiliza |
|---|---|
| Captar señales | Cada hora, Carrara extrae datos de Granola, Gmail, Calendar y Slack, y reconoce a cada compañero aunque use varias direcciones de correo. Composio facilita añadir nuevas fuentes. |
| Recordar | La memoria compartida vive en Neon Postgres, mientras que una aplicación nativa de macOS la replica en local para cada compañero. |
| Soñar y podar | Nada entra en el cerebro sin revisión. Una interfaz de aceptación dedicada mantiene cada recuerdo aprobado por una persona. La poda automatizada aún está por llegar. |
| Hablar y buscar | Los agentes se conectan mediante un servidor MCP propio, mientras que los compañeros usan la aplicación nativa de macOS. |
Coste y encaje. En fase temprana; precios no públicos. La apuesta interesante es el diseño que pone la revisión primero: acepta un crecimiento más lento del cerebro a cambio de no almacenar nunca algo que una persona no haya visto.
10. Slite Agent
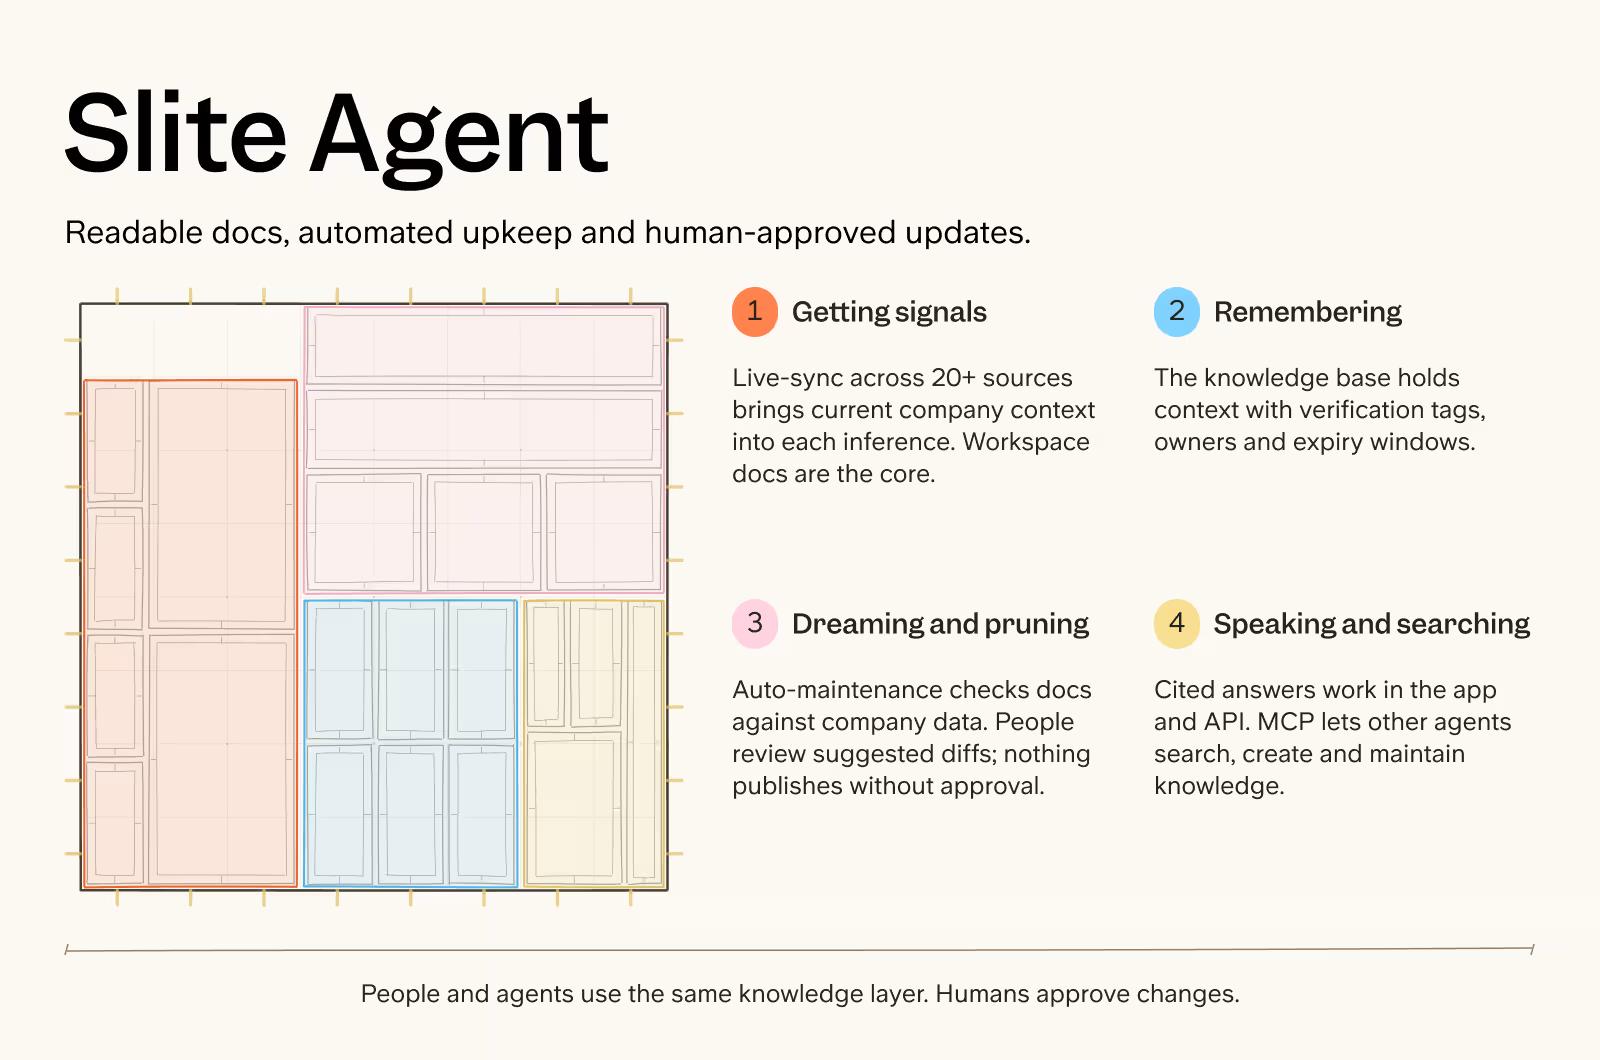
Slite conserva los documentos que la gente ya usa y añade a su alrededor revisión, caducidad, mantenimiento y respuestas con citas. Es nuestro propio producto, así que lee esta entrada como las decisiones de diseño que tomamos y no como un veredicto.
| Componente | Qué utiliza |
|---|---|
| Captar señales | Slite Agent se sincroniza en vivo con más de 20 fuentes, Slack, Drive, Notion, GitHub, Jira y más, para poder llevar el contexto de empresa más actual a cada inferencia. Los documentos y archivos adjuntos del espacio de trabajo son el núcleo. |
| Recordar | Las personas y los agentes incorporan contexto a la base de conocimiento de Slite con etiquetas de verificación, responsables y ventanas de caducidad que dejan claro su estado. Los documentos siguen siendo el almacenamiento. |
| Soñar y podar | Con el mantenimiento automático, Slite contrasta con regularidad tus documentos con el resto de los datos de tu empresa. Las actualizaciones sugeridas aparecen como diferencias lado a lado en una vista de triaje, donde tú decides qué cambia. Nada se publica sin aprobación. |
| Hablar y buscar | Slite Agent responde con citas en la aplicación y en la API, y da menos peso a las fuentes no verificadas. Su servidor MCP permite que otros agentes también busquen, creen y mantengan conocimiento. |
Coste y encaje. Suscripción por puesto. Pensado para equipos de 50 a 500 personas que quieren un company brain que se mantenga solo y siga siendo legible para las personas, sin que el contexto acabe dentro de una plataforma de la que no puedan salir.
En qué coinciden las personas que construyen company brains
Las empresas anteriores discrepan en casi todo: la estrategia de recuperación, grafo o no grafo, cuánto automatizar. En las herramientas que estudiamos encontramos cinco rerankers distintos, tres filosofías de búsqueda y ningún benchmark compartido.
Pero en cuatro cosas, todas las personas que entrevistamos llegaron al mismo punto.
- Mantendrás el company brain para siempre. En Slite nos contactan con regularidad empresas que ya intentaron construir un company brain internamente, y lo más difícil siempre es el mantenimiento. Un cerebro de construcción propia son en realidad dos trabajos: curar el contenido y rediseñar el sistema a medida que el sector se mueve. Gorgias puede permitirse ambos, pero para la mayoría de los equipos, el segundo trabajo es el que nadie presupuesta.
- La IA no está lista para escribir en el conocimiento de tu empresa sin supervisión. El conocimiento creado automáticamente funciona en los cerebros personales, porque no tienes conflictos contigo mismo. El contexto de empresa es distinto: los agentes fallan al distinguir un plan acotado de una larga conversación de Slack, aparentemente autorizada, sobre un posible cambio. Por eso todas las empresas que ofrecen una solución de company brain optan por defecto por el triaje humano: Pletor está construyendo una bandeja para enmiendas, Gorgias pasa cada corrección del grafo por un pull request revisado, los agentes de Sylph no pueden promover sus propios borradores, Carrara aprueba cada recuerdo, y nosotros construimos Agent Triage en Slite antes de lanzar el Agent.
- La captura tiene que ocurrir donde ocurre el trabajo. Incluso los usuarios más comprometidos con una base de conocimiento nos dijeron que no conseguían seguir alimentándola. "Tienes que ser muy deliberado a la hora de alimentar la máquina, y aun con la mejor de las intenciones por mi parte tratando de impulsar esa cosa, yo tampoco lo hacía", dijo Glen Sykes, Chief Product Officer de Spoor. Por eso la captura se está trasladando al propio trabajo: Gorgias extrae información de sus propias trazas de conversación, Pletor deduce enmiendas a partir de los chats, y Slite Agent observa la actividad en las herramientas conectadas en lugar de esperar a que alguien escriba las cosas.
- La gente seguirá haciéndole preguntas al cerebro. Los agentes harán más. mem0, Guru y Slite lanzaron servidores MCP este año, y Gorgias expone uno para equipos que priorizan el código. En cuanto una empresa ejecuta flujos de trabajo reales con agentes, las consultas de los agentes superan a las humanas en órdenes de magnitud.
¿Qué company brain necesitas?
Tres preguntas deciden la mayor parte: qué tamaño tiene tu equipo, qué es lo que más te preocupa y quién sería el responsable interno del cerebro.
| Si | Elige | Por qué |
|---|---|---|
| Ingenieros a los que les gustaría esto, 50 personas o menos, y la preocupación es el coste | Autoalojado (GBrain, Sylph, construcción propia) | Tienes los ingenieros y las ganas. Constrúyelo, sé su dueño y paga casi nada. |
| Ingenieros, 50 o menos, y la preocupación son las respuestas erróneas | SDK de memoria (mem0, Zep, Letta) más tu propio ajuste de la recuperación | Si la precisión te quita el sueño, querrás tener las manos en la pila de recuperación. |
| Ingenieros, pero más de 50 personas | Company brains dedicados | Tu equipo puede construirlo, pero con este tamaño nadie tiene tiempo para encargarse también de mantenerlo. |
| La preocupación es el esfuerzo de puesta en marcha | Company brains dedicados | Los cerebros dedicados se han vuelto rápidos de desplegar, y dentro de un año seguirás siendo dueño de tu contexto. |
| La preocupación es mantenerlo vivo | Company brains dedicados | El mantenimiento es lo que te preocupa. Elige la categoría que lo automatiza. |
| La preocupación es quién ve qué | Company brains dedicados | Los permisos tienen que estar integrados en la capa, no heredados de una plataforma de la que no puedes salir. |
| Nadie técnico, tiene que funcionar sin más | Company brains dedicados | Nadie va a pelearse con archivos YAML. Necesitas algo que funcione el día en que te registras. |
| Algunas personas técnicas, sin tiempo, y la preocupación es el coste | Autoalojado con una huella ligera (GBrain, Sylph) | Configuración ligera, archivos planos, coste de ejecución casi nulo, sin que se convierta en el trabajo a tiempo completo de alguien. |
Elijas lo que elijas, trata la soberanía del contexto como un requisito. El company brain tiene que ser su propia capa. Se sitúa por encima de las plataformas y de los modelos, y no le debe lealtad a ninguno de los dos.
Construir o comprar: cinco preguntas de arquitectura que conviene resolver primero
Antes de comprometerte a construir, hay cinco decisiones de arquitectura que todo equipo toma, tanto si construye como si compra.
¿Dónde viven los recuerdos del cerebro: en una base de datos o en archivos?
El backend de almacenamiento es la decisión menos diferenciadora de toda la pila. Los equipos que construyeron su propio cerebro lo han ejecutado sobre Markdown plano en un repositorio git, sobre almacenamiento de objetos y sobre Postgres, y han pasado de uno a otro sin tocar la estructura del conocimiento.
Postgres aparece como solución: es un sistema de archivos, siempre que cada entrada lleve un título, una descripción y un responsable.
Con lo que convivirás es con la forma de la memoria y con la capa de contexto que se la sirve a personas y agentes.
Si construyes, elige lo que tu equipo sepa operar. Si compras, pregunta si tu contexto se puede exportar como archivos planos, porque eso es lo que mantiene el cerebro como tuyo.
¿Registros estructurados o grafo de conocimiento, y dónde está la fuente de verdad?
La división tiene que ver con quién es dueño del dato.
Las entidades que pertenecen al sistema, como clientes, tablas y métricas, se quedan en el sistema que las produce, y el cerebro apunta a ellas en lugar de copiarlas.
El conocimiento que pertenece a las personas, como decisiones, procesos y definiciones, corresponde a documentos mantenidos con un estado fijado por una persona.
Esa base de conocimiento mantenida es la fuente de verdad, y la recuperación lee ambas en el momento de la consulta.
Lo que no necesitas es un grafo almacenado como tercera fuente de verdad. Se queda obsoleto con cada reorganización, y por eso defendemos que no necesitas un grafo de contexto.
Los constructores que entrevistamos tampoco se ponen de acuerdo sobre los grafos: unos apostaron su arquitectura por los grafos temporales, otros construyeron uno a mano, otros no entregan ninguno.
¿Quién puede ver qué?
Cuando todo el equipo y sus agentes extraen del mismo cerebro, hay que decidir quién ve qué documentos. Las personas siempre han podido abrir archivos que no estaban pensados para ellas, pero un agente busca en todo lo que puede alcanzar.
El patrón que funciona es exponer el cerebro a través de una única interfaz, normalmente un servidor MCP, y dar a cada agente un nivel de acceso, de modo que un agente de cara al cliente nunca toque datos financieros.
Construye si puedes trasladar tú mismo los permisos de todas las fuentes. Compra si necesitas que se trasladen desde las herramientas que ya usas.
Los permisos fueron la segunda mayor preocupación de nuestra encuesta, con un 63%, y nuestra guía sobre control de acceso de agentes de IA recoge los patrones al completo.
¿Quién lo mantiene veraz?
Un company brain sin responsable es como la nevera de la oficina. Todo el mundo sigue metiendo cosas, nadie siente que le toque tirar lo que se ha echado a perder, y pasados unos meses dejas de fiarte de todo lo que hay dentro.
Todo cerebro que funciona hoy llega a la misma respuesta: la IA propone, un responsable con nombre aprueba, como un pull request para el conocimiento.
Cuando dos ediciones compiten, el responsable del documento decide qué entra.
En Slite esto se establece en el nivel de mantenimiento, con un responsable por documento y una capa de comentarios para asignar revisores concretos.
Construye si estás dispuesto a mantener ese flujo de revisión mucho después del lanzamiento. Compra si nadie tiene ese tiempo.
El flujo de trabajo completo, desde la titularidad hasta las colas de revisión, está en nuestra guía de mantenimiento de la base de conocimiento.
¿Dónde deja de tener sentido construir?
Un equipo de cuatro personas puede construir un cerebro funcional en unas cuatro semanas, pero normalmente después de un año averiguando qué quiere, y con ingenieros que ya hayan lanzado sistemas con agentes.
La demo funcional es la parte fácil.
Construir son dos trabajos:
- curar el contenido,
- y rediseñar el sistema a medida que el sector se mueve.
De forma realista, un cerebro de construcción propia que perdure necesita 500 personas o más y unos cuantos ingenieros dedicados a él indefinidamente.
Por debajo de eso, la fila de autoalojado de la tabla anterior significa una configuración ligera de archivos planos, no un producto que tu equipo tenga que rediseñar una y otra vez.
Para equipos más pequeños, incluso uno en el que todo el mundo domina git y Claude, construir el tuyo es excesivo.
Cuando una base de conocimiento es el company brain
Hay una pregunta que ninguno de los artículos sobre company brains responde: ¿el cerebro se sitúa encima de tu base de conocimiento, o la base de conocimiento puede ser el cerebro?
Cada proveedor afirma que su propia capa es la buena. Nuestra respuesta, y la razón por la que construimos Slite Agent como lo hicimos, es que para la mayoría de los equipos los documentos en los que la gente ya confía son el almacenamiento adecuado, siempre que se cumplan tres condiciones.
Cada documento lleva un estado fijado por una persona: verificado, obsoleto, a punto de caducar.
Algo contrasta esos documentos con la realidad y propone correcciones, sin publicarlas por su cuenta. Y los agentes pueden acceder a la misma capa verificada que las personas, mediante MCP, con los mismos permisos.
Eso te da el mantenimiento automatizado de la familia dedicada, la legibilidad de los documentos planos y nada del bloqueo de los actores establecidos integrados.
Si esto suena a el cerebro que necesita tu equipo, reserva una demo o empieza con Slite Agent. Y si quieres las entrevistas completas que hay detrás de este artículo, están en Company Brain 101.
Preguntas frecuentes
¿Es Glean un company brain?
Glean es búsqueda empresarial con una capa de IA: encuentra y resume lo que ya existe en tus herramientas. No mantiene ni corrige ese conocimiento, y mantiene tu contexto dentro de su plataforma. Eso lo convierte en un actor establecido integrado y no en una capa independiente de company brain. Consulta nuestro análisis de Glean.
¿Existen company brains de código abierto?
Sí. GBrain y Sylph almacenan el cerebro como archivos planos en git. mem0, Graphiti (Zep) y Letta son capas de memoria de código abierto que puedes autoalojar. Todas dejan el mantenimiento en manos de tu equipo.
¿Cómo se mantiene actualizado un company brain?
A través del componente de soñar y podar: ejecuciones de consolidación, caducidad por tiempo, detección de desviaciones frente a herramientas en vivo y colas de revisión humana. Las herramientas de esta lista se diferencian sobre todo aquí, y es el componente que decide si el cerebro acaba convirtiéndose en la wiki obsoleta a la que sustituyó.
¿Cuánto cuesta el software de company brain?
Las opciones autoalojadas son gratuitas más allá de los costes de modelo y de alojamiento, pero el mantenimiento recae en tu equipo; en nuestra encuesta, el 27% de los equipos abandonó un cerebro de construcción propia por ese motivo. Los SDK de memoria se cobran por uso. Los company brains dedicados son suscripciones por puesto.
¿Basta con Notion para un segundo cerebro?
Para un segundo cerebro personal, a menudo sí. Para un company brain, Notion cubre el componente de recordar y poco más: nada contrasta las páginas con la realidad, y la búsqueda y los permisos se quedan dentro de la plataforma. Esa es la contrapartida de los actores establecidos integrados descrita más arriba.
¿Puede un company brain ejecutarse on-premise?
Los patrones autoalojados (GBrain, Sylph, un cerebro de construcción propia como el de Gorgias) y los SDK de memoria de código abierto, sí. Los company brains dedicados son sobre todo productos en la nube, así que pregunta a cada proveedor por la residencia de los datos y si tu contexto se puede exportar en archivos planos.
¿Necesitas un grafo de conocimiento para construir un company brain?
No. Algunas herramientas de esta lista usan uno, como Graphiti de Zep y el cerebro de Gorgias, mientras que GBrain y Sylph usan archivos planos. Un grafo almacenado es una decisión de recuperación, no un requisito, y necesita un cuidado constante a medida que la empresa cambia. La recuperación con agentes sobre una base de conocimiento mantenida consigue las mismas respuestas de varios saltos sin ese mantenimiento.