Le docs as code fait partie de la documentation technique moderne depuis plus de dix ans. En 2015, Riona MacNamara a expliqué lors de Write the Docs comment l'adoption du docs as code avait transformé la documentation chez Google.
Et on comprend pourquoi l'approche est devenue populaire.
Si vous dirigez une équipe d'ingénierie, le docs as code vous permet de garder la documentation au plus près du code qu'elle décrit.
Vos ingénieurs peuvent travailler dans des outils qu'ils connaissent déjà, et les modifications de la documentation peuvent passer par la même revue de pull request, les mêmes contrôles d'intégration continue (CI) et le même processus de publication que les modifications de code qu'elles décrivent.
Ce fonctionnement repose toutefois sur deux hypothèses : les personnes qui maintiennent la documentation travaillent déjà dans Git, et la plupart des changements qui rendent cette documentation obsolète se produisent près du dépôt.
À mesure que l'équipe grandit, le produit et le support détiennent davantage de contexte, les releases touchent plus de systèmes, et une partie du raisonnement derrière le code n'est jamais consignée nulle part.
Dans cet article, nous verrons ce qui change lorsque ce fonctionnement s'étend au-delà de vos ingénieurs et du dépôt, et pourquoi ces changements comptent pour les équipes en croissance qui maintiennent des connaissances techniques.
Points clés
- Le docs as code convient à la documentation proche du code lorsque les personnes qui la maintiennent travaillent déjà dans Git.
- Un processus basé sur Git vous donne l'historique des commits, les diffs, la revue de pull request et les contrôles CI pour les modifications apportées à la documentation. Mais il ne peut pas signaler une page non modifiée qui aurait dû l'être elle aussi.
- Lorsque le produit, le support, les rédacteurs et d'autres équipes commencent à apporter du contexte technique, un parcours de contribution limité à Git laisse davantage d'informations utiles dans Slack, dans les tickets et dans la tête des gens.
- Votre dépôt conserve les connaissances d'ingénierie que les gens y consignent. Les décisions, les compromis, les solutions de contournement et le contexte historique restent tacites tant que quelqu'un ne les met pas par écrit.
- Vous pouvez garder le docs as code pour la documentation qui doit rester proche du code, tout en offrant au reste de l'équipe un espace maintenu pour les connaissances qui dépendent d'autres systèmes et du contexte humain.
Qu'est-ce que le docs as code ?
Le docs as code (ou documentation as code) est une approche de la documentation technique qui s'appuie sur les outils et les processus du développement logiciel pour rédiger, relire, versionner, tester et publier la documentation.
Write the Docs, une communauté mondiale de spécialistes de la documentation, définit le docs as code comme le fait d'utiliser les mêmes outils et processus que les développeurs pour le logiciel, notamment les outils de suivi des tickets, Git, le balisage en texte brut, la revue de code et les tests automatisés.
Un dispositif docs-as-code typique comprend :
| Étape du processus | Ce qui se passe | Outils courants |
|---|---|---|
| Rédaction | La documentation est rédigée sous forme de fichiers source en texte brut. | Markdown, reStructuredText, AsciiDoc |
| Gestion de versions et relecture par les pairs | Les modifications sont commitées sur une branche, relues sous forme de diffs et fusionnées via une pull request. | Git, GitHub, GitLab, Bitbucket |
| Contrôles CI | Des contrôles automatisés valident les liens, le style, la syntaxe et le build de la documentation. | GitHub Actions, GitLab CI, Vale, markdownlint |
| Build et publication | Un générateur de site statique transforme les fichiers source en site de documentation consulté par les lecteurs. | MkDocs, Docusaurus, Sphinx, Hugo, Jekyll |
Par exemple, un ingénieur qui documente une nouvelle fonctionnalité met à jour la source Markdown, commite la modification sur une branche et ouvre une pull request. Les relecteurs examinent le diff en parallèle de la modification de code associée, les contrôles CI s'exécutent et, une fois la pull request fusionnée, le build de la documentation peut publier la page mise à jour.
Pourquoi les équipes d'ingénierie utilisent le docs as code
Les équipes d'ingénierie utilisent le docs as code à peu près pour la même raison qu'elles utilisent Git pour le code : la documentation bénéficie d'un historique des modifications versionné et relisible.
Pour les équipes d'ingénierie, cela présente quatre avantages concrets :
- La fonctionnalité et sa documentation peuvent être livrées dans la même pull request. Les relecteurs voient la modification de code et la mise à jour de la documentation dans le même contexte de revue.
- Chaque modification de la documentation a un historique de commits. Les diffs, les commits, les auteurs et les versions précédentes permettent de voir facilement ce qui a changé et quand.
- La documentation liée aux releases peut suivre la release. Les références d'API, les notes de migration et la documentation d'intégration peuvent évoluer au même rythme que le code qu'elles décrivent.
- La CI se charge des contrôles mécaniques. Les linters, les vérifications de liens, les contrôles de statut et les builds de la documentation détectent les erreurs de mise en forme et de build avant la publication.
Au-delà de ces avantages concrets, on attend souvent aussi du docs as code qu'il résolve deux problèmes de documentation plus importants :
- La fraîcheur. Si la documentation reste proche du code, les équipes devraient être plus enclines à la mettre à jour à mesure que le produit évolue.
- Moins de silos d'information. Si les contributeurs partagent un même processus, les connaissances techniques devraient moins risquer de disparaître dans des outils séparés ou chez des individus.
Pour que l'une ou l'autre de ces promesses tienne, il faut encore que quelqu'un repère quelles pages demandent de l'attention, et que les personnes qui détiennent le contexte manquant disposent d'un parcours de contribution qu'elles utiliseront vraiment. Comme vous le verrez dans les sections suivantes, ces deux promesses peuvent échouer.
Quand le docs as code est la bonne approche
Dans certains cas, le docs as code est exactement le dispositif qu'il vous faut :
- Pour une petite équipe composée surtout d'ingénieurs. Tout le monde suit déjà le même dépôt, la documentation peut donc rejoindre le processus de pull request sans créer un processus supplémentaire à maintenir pour l'équipe.
- Pour la documentation d'API et de référence. Lorsqu'un endpoint, un paramètre ou un SDK change, la référence doit souvent changer avec lui. Les mêmes relecteurs comprennent généralement les deux côtés de la modification.
- Pour la documentation technique liée aux releases. Les notes de migration, la documentation d'intégration et les contenus similaires gagnent à partager le versionnage et le cycle de revue de la release.
Tom Johnson, rédacteur technique API chez Google qui a auparavant travaillé chez Amazon, préfère toujours le docs as code dans l'ensemble, mais reconnaît ouvertement les frictions liées à Git qu'il crée pour des contributeurs aux niveaux techniques différents.
Dans un article de 2024, il explique que Git peut devenir difficile pour des équipes de rédacteurs aux profils techniques variés, même lorsque le reste du processus docs-as-code fonctionne bien.
Son argument est logique : le docs as code peut rester précieux alors même que Git devient plus difficile pour certaines des personnes censées maintenir la documentation.
Posez-vous donc deux questions :
- Qui maintient réellement cette documentation ?
- Où se produisent les changements qui la rendent obsolète ?
Si les deux réponses désignent toujours les ingénieurs et le dépôt, le docs as code fait exactement ce que vous attendez de lui. En revanche, dès que les réponses commencent à citer le support, le produit, Slack, Linear, Jira, les conversations avec les clients et des personnes extérieures à l'ingénierie, vous avez un problème : votre système de documentation a dépassé le cadre du dépôt.
Pourquoi le docs as code ne suit plus quand l'équipe grandit
Il n'existe pas d'effectif précis à partir duquel une équipe dépasse le docs as code. Ce qui finit par changer, c'est la charge de travail autour du dépôt : davantage de personnes doivent contribuer, davantage de systèmes peuvent modifier ce que la documentation devrait dire, et davantage de connaissances d'ingénierie sont créées en dehors de Git.
Voici à quoi ressemble la progression jusqu'à ce point :
| Étape | Ce qui commence à coincer |
|---|---|
| Étape 1 : cinq ingénieurs, un dépôt | Très peu de choses. Les mêmes personnes vivent déjà dans Git et sont généralement responsables à la fois du code et de son explication. |
| Étape 2 : la même équipe commence à livrer plus vite | Plus de releases signifie plus d'occasions pour les pages existantes de prendre du retard, y compris des pages que personne n'a touchées dans la pull request qui a modifié le produit. |
| Étape 3 : d'autres contributeurs doivent s'impliquer | Les rédacteurs techniques, le support, le produit et d'autres équipes ont un contexte utile, mais pour l'intégrer à la documentation, ils doivent désormais passer par un processus de contribution d'ingénierie. |
| Étape 4 : l'entreprise s'appuie sur Git pour une documentation plus large | Les permissions, la responsabilité des contenus, la prolifération des dépôts, des processus différents et les connaissances créées hors de Git transforment un processus de documentation en un problème plus large de maintenance des connaissances. |
Une fois arrivé à l'étape quatre, tenir la documentation à jour va bien au-delà de la modification du Markdown quand le code change. Quelqu'un doit désormais relier les changements de plusieurs systèmes aux bonnes pages et recueillir le contexte de personnes qui n'ouvriront peut-être jamais le dépôt.
La gestion de versions ne garde pas la documentation à jour
Git peut tout faire correctement alors que la documentation est fausse.
Lors de la sortie d'une fonctionnalité, par exemple, l'ingénieur met à jour le code, les tests passent, la CI reste au vert, la pull request est fusionnée et le build de la documentation réussit.
Mais la release modifie aussi une étape de configuration existante mentionnée dans un ancien fichier source Markdown, et personne ne touche à ce fichier.
Le pipeline est au vert alors que la documentation est déjà obsolète.
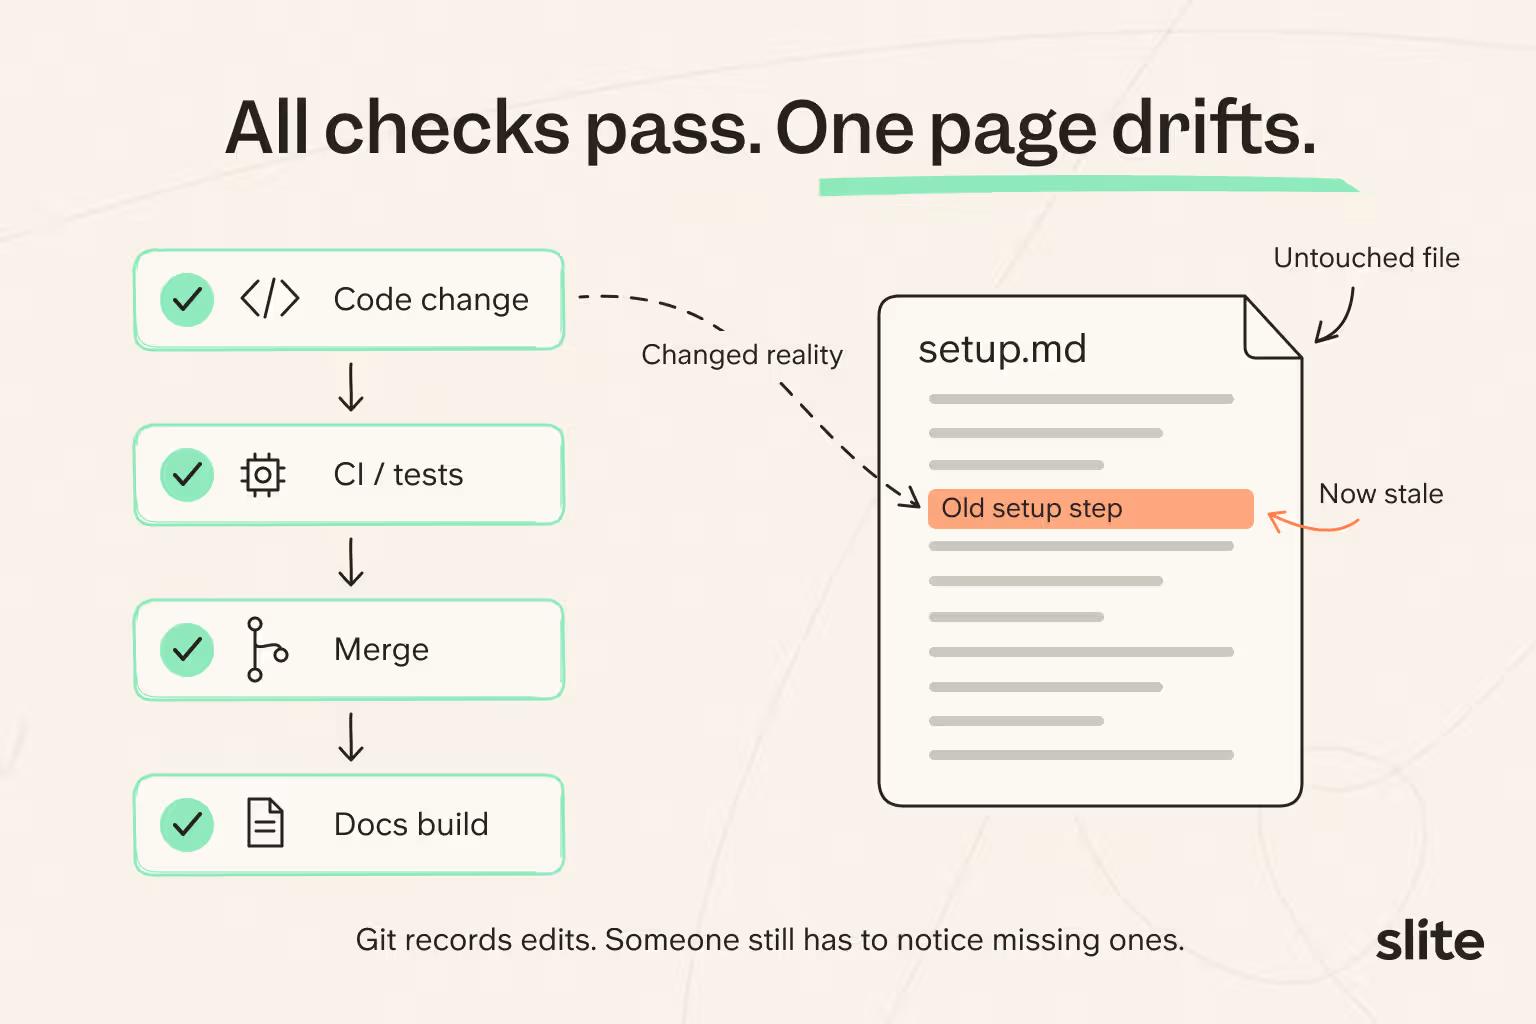
Git a fait exactement ce qu'il était censé faire. Il a enregistré les commits et les diffs des fichiers modifiés. Mais il ne pouvait pas vous dire quelle documentation non modifiée aurait dû changer elle aussi.
Les équipes qui maintiennent une documentation répartie sur plusieurs dépôts GitHub nous disent la même chose. Une équipe avec laquelle nous avons échangé expliquait que sa documentation ne suivait jamais le rythme des releases :
« Toujours obsolète. Toujours. Chaque semaine, on livre. »
Et quand on regarde les dates de dernière modification, c'est encore plus trompeur. Une page peut être modifiée le lundi, un changement produit peut être livré le mardi, et le mercredi, vous avez une date de modification récente posée sur une documentation obsolète.
À ce stade, les connaissances deviennent obsolètes au sein d'un processus docs-as-code pourtant bien mené. La page obsolète paraît normale à tout le monde, ce qui la rend malheureusement encore plus facile à manquer.
Lorsqu'un collègue finit par tomber sur une mauvaise réponse, il commence à se demander ce qui d'autre pourrait être obsolète. Ce scénario se répète quelques fois, et les collègues préfèrent alors demander à l'ingénieur qui « sait vraiment », parce qu'ils ne font plus confiance à la documentation comme source de vérité fiable.
La contribution via Git peut renforcer les silos d'information
La contribution via Git fonctionne sans accroc lorsque les personnes qui détiennent les connaissances vivent déjà dans Git. Dès que du contexte utile se trouve chez le produit, le support, les opérations ou d'autres équipes, le processus de contribution lui-même peut devenir la raison pour laquelle ces informations n'atteignent jamais la documentation.
Pour un ingénieur, ouvrir une pull request, travailler en Markdown et suivre les conventions du dépôt n'a rien d'inhabituel. Pour une personne du support, du produit ou des opérations, corriger une seule phrase erronée peut impliquer de gérer des branches, des permissions, des conventions Markdown et une revue de code avant que la correction n'arrive dans la documentation.
Johnson l'a vécu chez Amazon. Selon lui, une équipe a durci son processus de branches Git après qu'un contenu non publié a été fusionné dans une branche de production, et le processus est devenu si complexe qu'un nouveau rédacteur avait peur de faire la moindre petite modification.
Selon Johnson :
« Le processus vous faisait réfléchir à deux fois avant de corriger une simple faute de frappe. »
Il affirme toujours préférer le docs as code dans l'ensemble. Le processus présente de vrais avantages. La friction vient du fait de demander à toutes les personnes qui détiennent du contexte utile d'adopter un processus d'ingénierie simplement pour corriger la documentation.
Nous avons entendu des inquiétudes similaires lors de conversations avec des équipes d'ingénierie. Dans une entreprise, les contributeurs non techniques trouvaient GitHub difficile à mettre à jour : la documentation est devenue obsolète et les gens se sont rabattus sur Slack pour poser leurs questions.
Imaginez qu'un agent du support repère une étape de configuration incorrecte en aidant un client.
Corriger la page implique de passer par une pull request ; envoyer « au fait, cette étape a changé » dans Slack prend dix secondes. Le message l'emporte.
La correction existe, mais n'atteint jamais la documentation. Vous vous retrouvez avec un dépôt partagé alors que le contexte utile reste éparpillé entre Slack, les tickets et les personnes qui connaissent la réponse.
Le dépôt ne contient pas tout ce que savent vos ingénieurs
Même si chaque contributeur est à l'aise avec Git, le dépôt ne contient toujours que ce que les gens y ont réellement consigné.
Le code vous donne l'implémentation. Les README, les architecture decision records (ADR) et les autres documents du dépôt apportent des explications supplémentaires. Mais une grande partie du contexte d'ingénierie se trouve dans le raisonnement derrière le travail :
- Raisonnement architectural : pourquoi l'équipe a choisi cette approche et ce qu'elle cherchait à optimiser.
- Compromis : quelles alternatives ont été envisagées et pourquoi elles ont été écartées.
- Solutions de contournement : ce que les ingénieurs expérimentés savent faire en pratique lorsque le chemin documenté ne suffit pas.
- Contexte historique : d'anciennes décisions qui expliquent pourquoi une partie inhabituelle du système existe encore.
- Contexte des incidents et des clients : les enseignements tirés des cas de support, des incidents et des conversations internes qui ont changé la façon de gérer le système.
Une partie de ce contexte finit dans un ADR, un ticket ou un README. Une grande partie reste dans des fils Slack, des réunions et la tête de chaque ingénieur, sous forme de connaissances tribales.
Une équipe avec laquelle nous avons échangé estimait qu'environ 80 % de ses connaissances opérationnelles restaient tacites, enfermées dans la tête des gens.
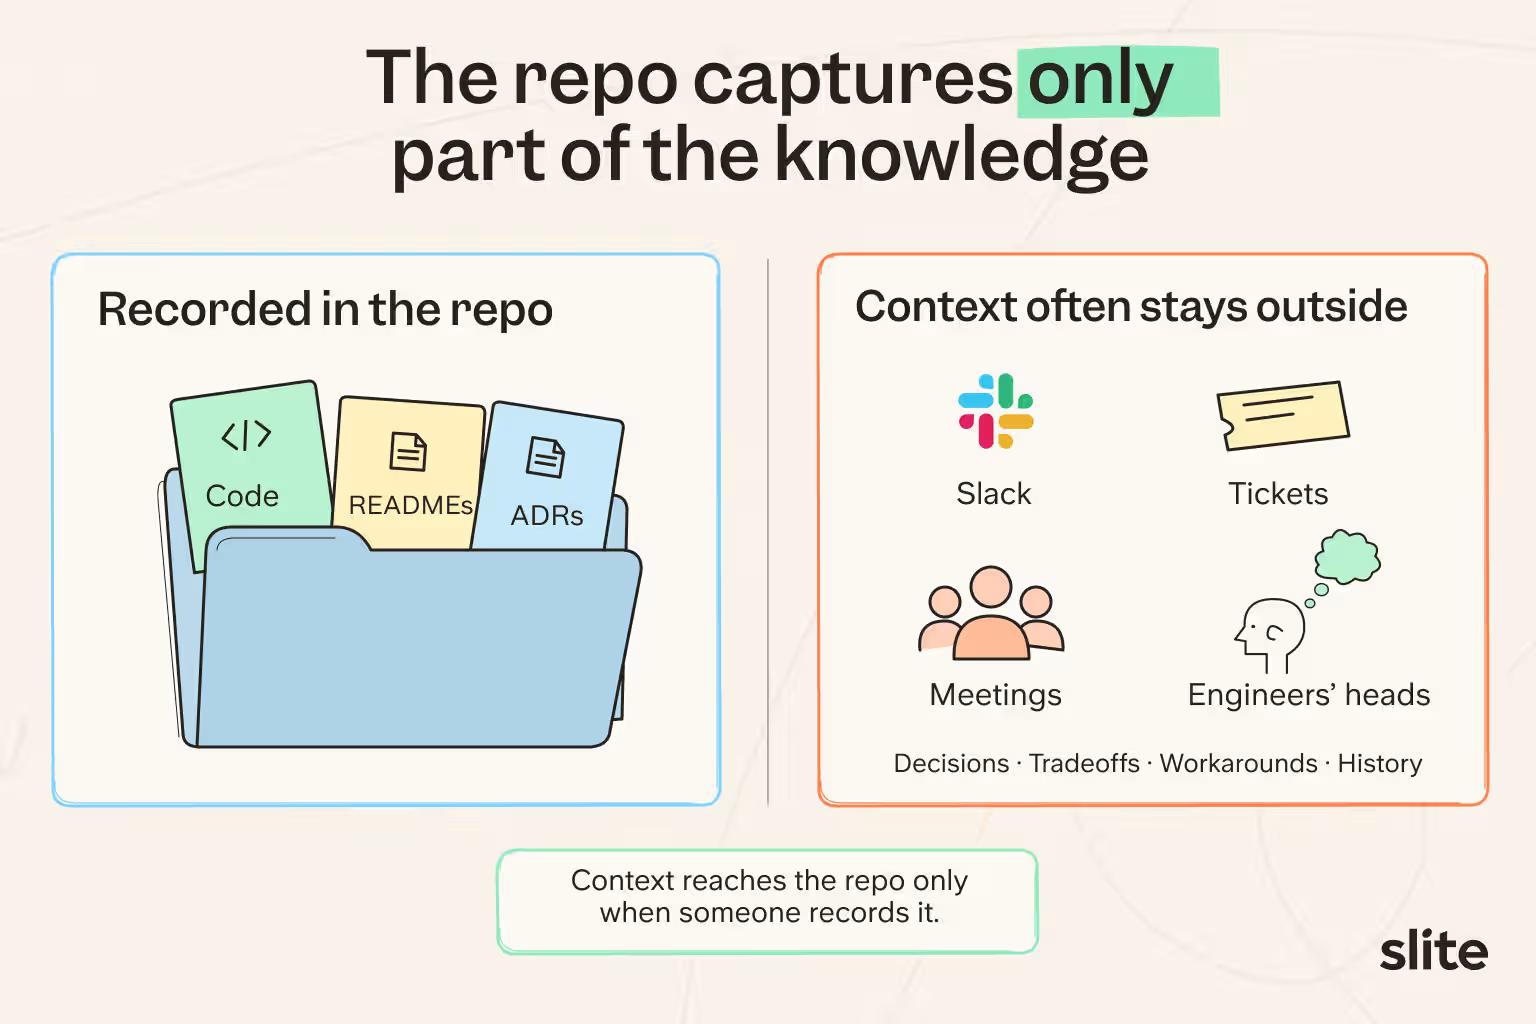
Une équipe en croissance finit donc par mener deux chantiers en parallèle :
- Garder exactes les connaissances déjà documentées à mesure que le produit évolue.
- Capturer les décisions, les solutions de contournement et le contexte qui ne sont jamais entrés dans le dépôt.
Dès que vous devez gérer les deux, Git ne suffit plus. Il vous faut aussi une couche capable de surveiller les changements dans les outils qu'utilise votre équipe et d'offrir aux gens un endroit où capturer le contexte qui resterait sinon en dehors de Git.
Permettez à tout le monde de contribuer à la documentation
Avec Slite, les personnes de toute l'organisation peuvent contribuer à la documentation sans passer par le même processus Git.
- Une personne du support ou du produit peut ouvrir le document et le modifier directement dans son éditeur WYSIWYG.
- Les développeurs peuvent rester dans leur outil ou environnement d'IA préféré, comme Claude, ChatGPT ou Cursor, et contribuer via le MCP de Slite. Le MCP inclut aussi des appels d'outils pour les commentaires, ce qui leur permet de lancer, lire, répondre à et résoudre des discussions sans quitter cet environnement.
- Les équipes peuvent aussi utiliser l'API de Slite pour créer et mettre à jour la documentation de manière programmatique.
Plaid, par exemple, comptait près de 3 000 documents internes en Markdown dans Git lorsque l'entreprise a décidé de reconstruire son système de documentation interne.
L'un de ses objectifs était de remplacer le processus de pull request GitHub pour les modifications de documentation par une édition WYSIWYG.
Après avoir évalué trois plateformes, Plaid a choisi Slite, et tous ses utilisateurs pilotes l'ont préféré, citant notamment son expérience WYSIWYG intuitive.
Six mois après la migration, le nombre d'auteurs de documentation actifs chaque mois avait augmenté de 63 %, passant de 65 à 107.
Les équipes en croissance ont besoin d'une couche de connaissances auto-entretenue au-dessus du dépôt
Dès que votre documentation dépend de modifications de code, de tickets, de conversations avec le support et de personnes de toute l'entreprise, Git ne suffit plus.
Il vous faut un système capable de remarquer quand la réalité change, de relier ces changements à la bonne documentation et de laisser les humains garder la main sur les connaissances de confiance.
Voici comment :
1. Donnez aux contributeurs un seul endroit où travailler
Avec l'éditeur WYSIWYG de Slite, les ingénieurs, le produit, le support, les rédacteurs et les autres experts métier disposent d'un seul endroit pour ajouter des explications, des décisions et du contexte issus de leur propre travail, à côté du reste de la documentation.
2. Reliez la documentation aux endroits où le travail évolue
Les équipes d'ingénierie peuvent connecter des sources comme GitHub, GitLab, Jira et Linear. Slite Agent peut croiser la base de connaissances avec l'activité dans ces outils et utiliser ces changements comme des signaux indiquant qu'un document existant mérite peut-être un nouvel examen.
3. Transformez ces signaux en actions concrètes pour l'équipe
Lorsque Slite Agent détecte qu'un document est probablement devenu obsolète, il peut identifier la documentation concernée et rédiger une proposition de mise à jour, au lieu d'attendre que quelqu'un découvre la page obsolète puis la corrige.
4. Laissez les humains garder la main sur la source de vérité
Chaque proposition de mise à jour est envoyée dans Triage pour une relecture humaine : une personne qui comprend le contexte peut ainsi accepter, affiner ou rejeter la modification avant qu'elle ne fasse partie de la source de vérité.
Votre processus de documentation basé sur Git peut rester en place pour la documentation qui a sa place dans le dépôt. Slite vient se placer au-dessus de ce processus comme une couche de connaissances auto-entretenue pour les informations qui dépendent de changements dans d'autres systèmes et du contexte apporté par des personnes de toute l'entreprise.
En somme, le docs as code peut rester une partie de votre système de documentation. Il n'a simplement pas à constituer le système tout entier.
Si vous souhaitez voir comment Slite relie les connaissances techniques aux outils d'ingénierie que votre équipe utilise déjà, réservez une démo pour une présentation guidée.
FAQ
Quelles sont les bonnes pratiques du docs as code ?
Gardez la documentation liée au code au plus près de celui-ci, mettez à jour les pages directement concernées dans la même pull request, automatisez les contrôles utiles et désignez des responsables clairs. Si des changements importants se produisent en dehors du dépôt, assurez-vous que votre processus de maintenance peut aussi les détecter.
Quels sont quelques exemples de docs as code ?
Parmi les exemples courants figurent la documentation d'API, les guides pour développeurs, la documentation d'intégration, les notes de migration et les contenus de référence technique rédigés en Markdown ou dans un autre format texte brut, et gérés via Git.
Quels outils utilise-t-on pour le docs as code ?
Les outils courants incluent GitHub, GitLab ou Bitbucket pour l'hébergement des dépôts et la revue de pull request, Markdown ou AsciiDoc pour la rédaction, Vale ou markdownlint pour les contrôles CI, et Docusaurus, MkDocs ou Sphinx pour la génération de sites statiques. Slite peut s'ajouter à cette stack comme couche de connaissances maintenue pour la documentation interne qui dépend de changements et de contexte extérieurs à Git.
Quelle place pour l'IA dans le docs as code ?
L'IA peut aider à rédiger la documentation, repérer les pages probablement obsolètes et les signaler pour relecture après une évolution du produit concerné. La relecture humaine reste essentielle avant que les mises à jour proposées par l'IA ne deviennent une documentation de confiance.
Le « docs like code » est-il la même chose que le docs as code ?
Oui. « Docs like code » et « docs as code » désignent généralement la même approche : gérer la documentation avec Git, un balisage en texte brut, la relecture par les pairs, des contrôles automatisés et l'intégration continue.