Vous avez sans doute déjà croisé le terme « Company Brain ».
Il est apparu dans un essai de VC, puis dans un dépôt viral, puis dans une Request for Startups de Y Combinator, et il occupe désormais la moitié des fils sur l'IA dans votre timeline. Quelque part entre le cinquième et le dixième post, vous avez probablement acquiescé sans pouvoir dire ce que c'est réellement.
C'est pourquoi, pour certains, un Company Brain désigne un graphe de contexte, une carte connectée de tout ce qu'une entreprise produit. Pour d'autres, c'est une recherche d'entreprise avec de meilleures manières.
Pour d'autres encore, c'est un wiki qui se met à jour tout seul, la version entreprise de ce qu'Andrej Karpathy a construit pour ses propres lectures, ou de ce que Garry Tan a publié en open source sous le nom de GBrain. Chacun de ces éléments est une vraie pièce du puzzle. Aucun n'est l'ensemble.
Dans cet article, nous allons tenter de vous donner un aperçu de ce que c'est, d'où ça vient et pourquoi tout le monde en veut un.
Nos statistiques sur les company brains montrent que 70 % des équipes connaissent le terme alors que seulement 20 % en ont un.
Points clés
- Un Company Brain est une couche de contexte persistante qui rassemble les connaissances partout où une entreprise les crée et rend ce contexte utilisable à la fois par les personnes et par les agents IA.
La pratique qui consiste à assembler ce contexte pour un modèle s'appelle le context engineering.
- Il compte aujourd'hui parce que les agents ont changé les enjeux : les gens peuvent contourner un contexte manquant, mais les agents ne savent que ce qu'on leur donne et oublient entre deux sessions, si bien que l'éparpillement du contexte est passé de nuisance à dépendance.
- Le terme a convergé à partir de plusieurs fils en un an environ : le « second brain » personnel, la recherche d'entreprise, les graphes de contexte de Foundation Capital (décembre 2025), le wiki LLM de Karpathy, le GBrain open source de Garry Tan et la Request for Startups de l'été 2026 de YC.
- C'est une catégorie à part entière, distincte de la recherche d'entreprise et d'un chatbot greffé sur un wiki. Son vrai travail est de capturer le « pourquoi » derrière les décisions plutôt que de simplement retrouver des documents.
- Brain personnel et Company Brain se séparent sur la question de la propriété : un brain personnel sert une seule personne, tandis qu'un Company Brain ajoute des permissions, de la gouvernance, des sources contradictoires et une confiance partagée.
- Choisissez un outil personnel ou open source quand la mémoire vous appartient ou que votre équipe est petite et soudée ; choisissez un Company Brain managé comme Slite quand les niveaux d'accès diffèrent, que les sources se contredisent, que des données sensibles sont en jeu ou que des agents peuvent agir.
Company brain : la définition de travail
Un company brain est une couche de contexte persistante. Il rassemble les connaissances partout où une entreprise les crée, et il rend ce contexte utilisable à la fois par les personnes et par les agents IA.
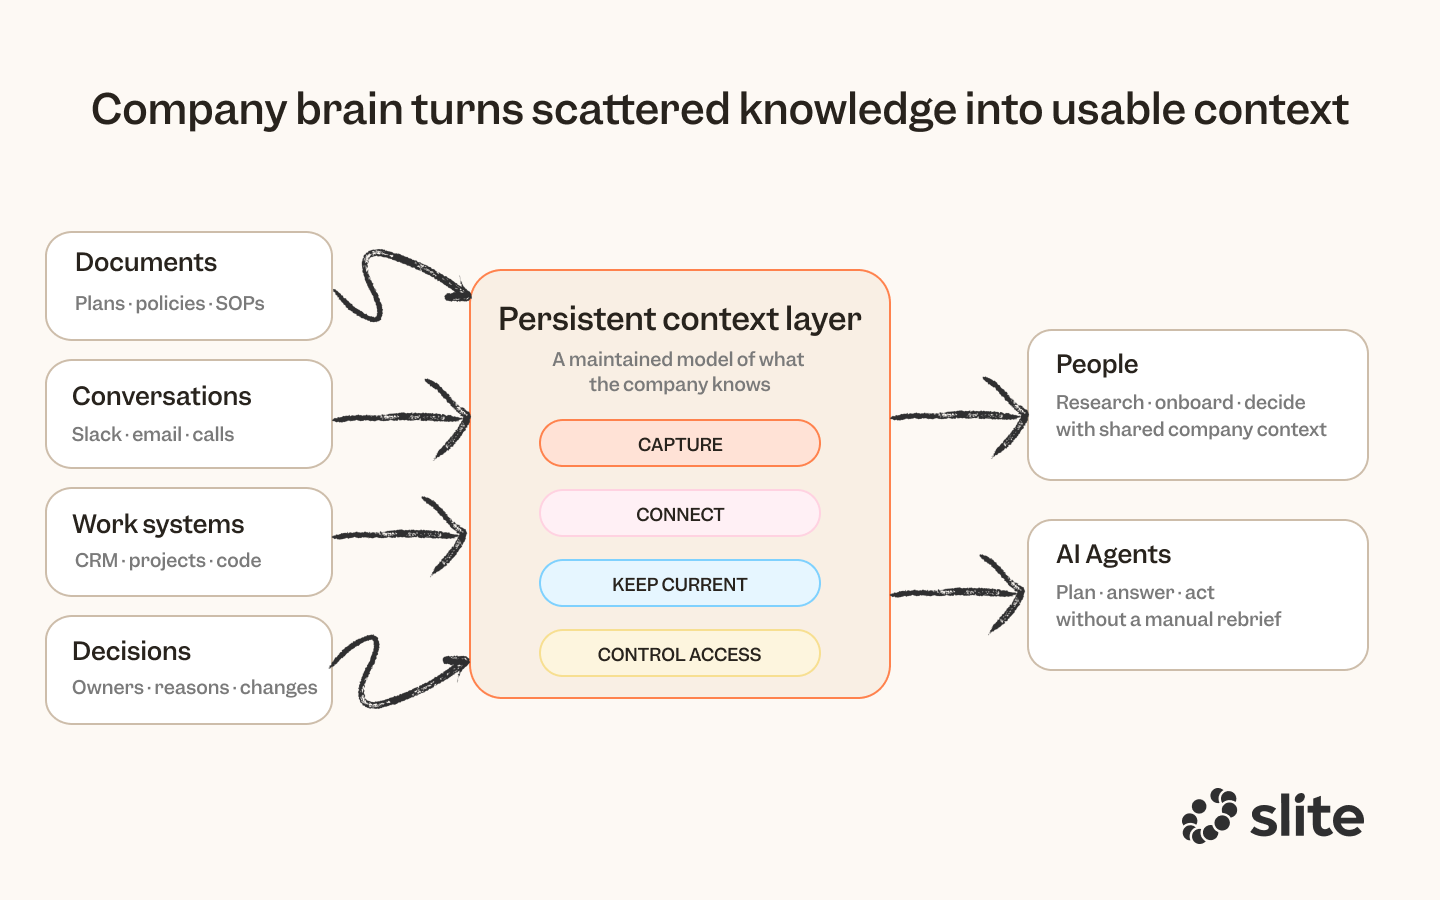
Les problèmes sous-jacents sont anciens et peu glamour :
- L'information s'éparpille.
- La mémoire institutionnelle part avec les gens.
- Les documents deviennent obsolètes et personne ne le remarque.
Cela crée de l'éparpillement du contexte, mais les humains ont toujours su le contourner.
Ce qui a changé au cours de l'année écoulée, c'est qui a besoin de la réponse.
Les gens sont excellents pour contourner un contexte manquant. Vous demandez à la personne à côté de vous.
Un agent ne fait rien de tout cela. Il ne sait que ce que vous lui donnez, et il oublie entre deux sessions à moins que quelque chose ne se souvienne à sa place.
Une nuisance est donc devenue une dépendance au moment où les gens ont commencé à briefer des agents pour faire du vrai travail.
Un company brain est censé résoudre l'éparpillement du contexte en donnant aux agents chaque information pertinente sur votre entreprise.
D'où vient le company brain ?
Avant que quiconque n'utilise l'expression, deux désirs distincts existaient sur le marché depuis des années, chacun avec son public, ses outils et aucune vraie raison de se rencontrer.
L'émergence du Second Brain
Les gens voulaient garder ce qu'ils lisaient, apprenaient, créaient et remarquaient. Tiago Forte a popularisé de la façon la plus visible la méthode moderne du second brain, et toute une génération de preneurs de notes a construit des systèmes autour d'elle.
Mais la promesse plus profonde était plus discrète et plus émotionnelle. Si vous capturiez assez de votre propre pensée et la reliiez bien, vous pourriez enfin voir la forme de votre propre esprit depuis l'extérieur.
Puis la recherche d'entreprise est arrivée à la fin des années 2010
Les entreprises avaient de l'information éparpillée bien avant d'avoir de l'IA. Les mêmes cinq questions revenaient à chaque onboarding de nouvelle recrue. La recherche d'entreprise a été la réponse : elle a rendu les choses trouvables à travers des outils qui n'avaient aucune envie de se parler.
Ce qu'elle n'a jamais fait, c'est maintenir quoi que ce soit. Elle allait chercher. Elle ne gardait pas un modèle à jour du fonctionnement de l'entreprise, et elle ne détenait certainement pas ce modèle sous une forme sur laquelle un autre système pouvait agir.
Un désir concernait donc la mémoire d'une personne, et l'autre l'accès d'une entreprise. Ils sont restés séparés parce que rien ne les forçait à se rejoindre. Puis, en un an environ, quatre choses se sont produites qui les ont réunis.
En 2025, une société de capital-risque a inventé les Context Graphs
Le 22 décembre 2025, Jaya Gupta et Ashu Garg, de Foundation Capital, ont publié un article soutenant que les graphes de contexte représentaient une opportunité énorme. Le cadrage qui comptait allait au-delà de « stocker plus de données d'entreprise » : la plupart des systèmes ne conservent qu'une partie d'un projet plus large, et aucun d'eux, mis ensemble, ne forme le contexte expliquant pourquoi quelque chose s'est produit au départ.
Par exemple, imaginons que vous lanciez un nouveau projet marketing à partir d'une discussion à la machine à café avec votre manager.
- Son document de proposition sera dans Slite
- Son avancement sera dans Notion, ClickUp, Asana
- Ses livrables de travail seront dans Figma et Google Docs
- Son suivi sera dans BigQuery et Google Analytics
Une IA pourrait aller chercher ces éléments, mais elle ne peut pas aller chercher les discussions à la machine à café ou les fils Slack où les grandes décisions ont réellement été prises pendant l'exécution.
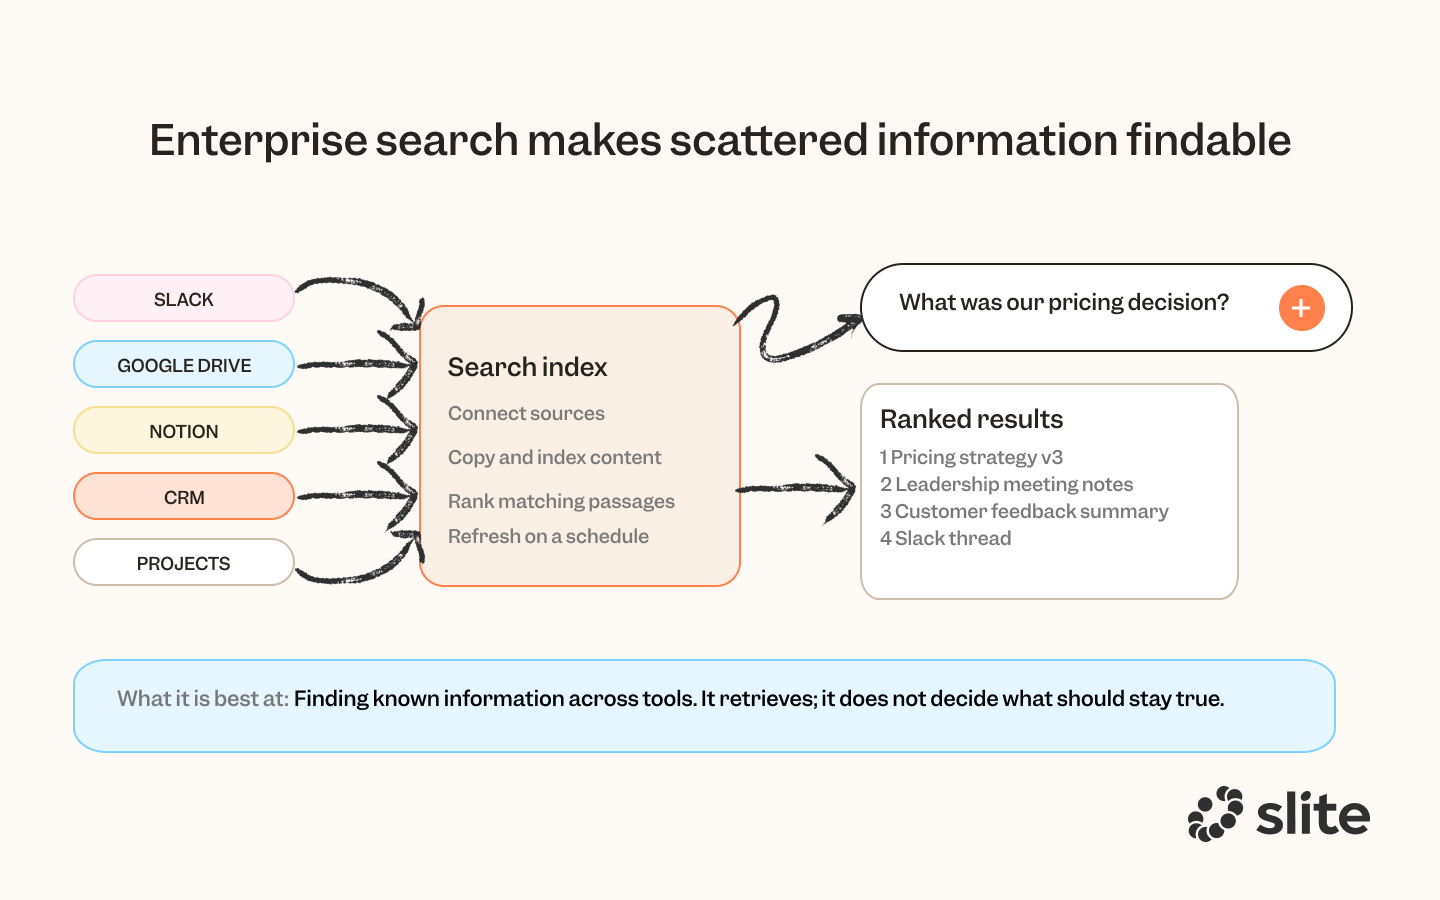
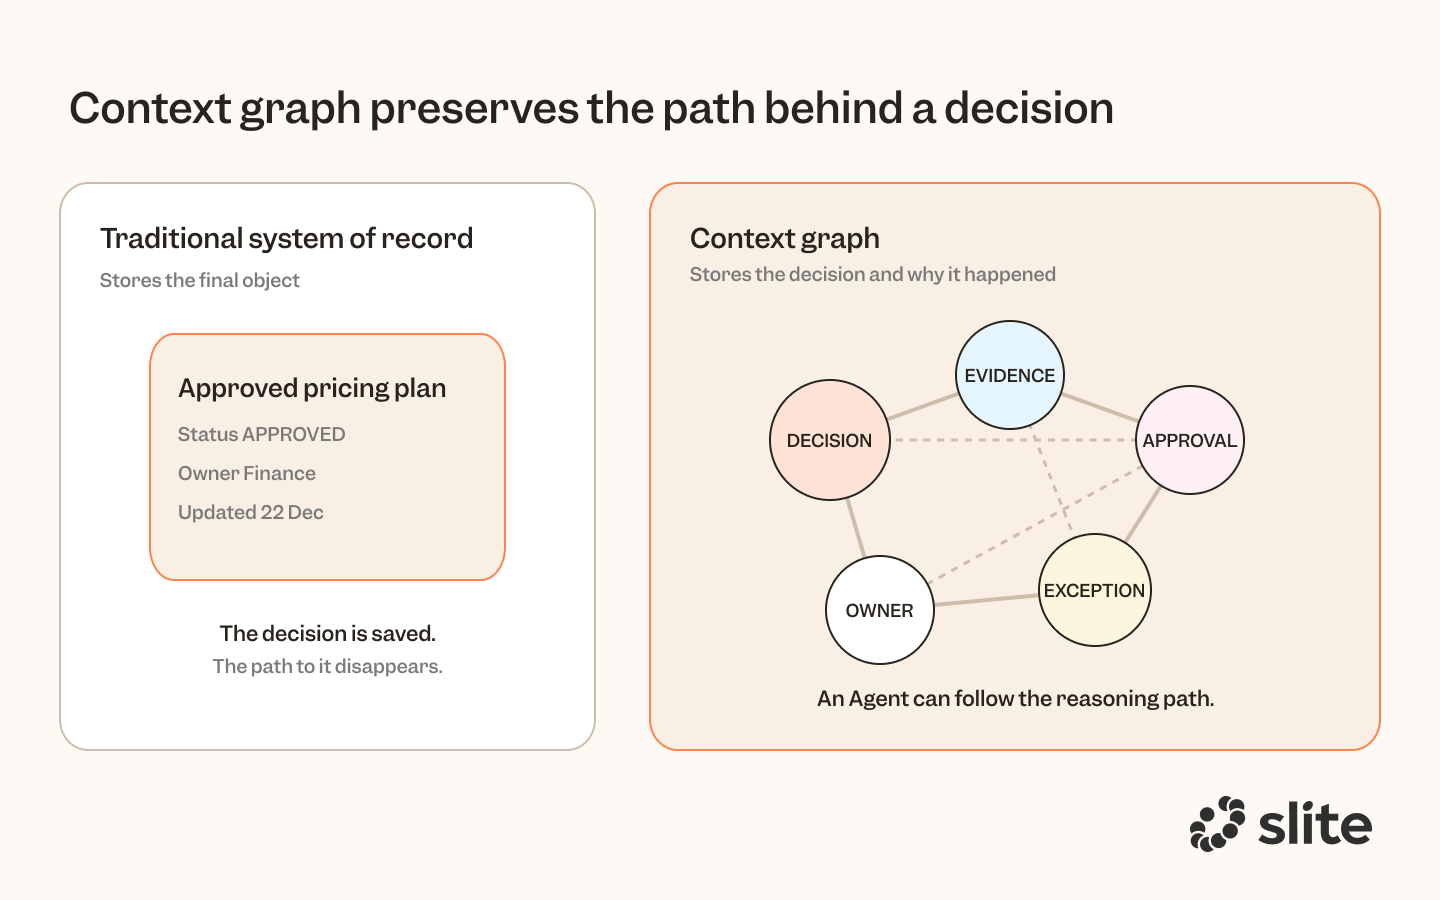
Jaya et Ashu ont donc soutenu que les entreprises avaient besoin d'un Context Graph qui relie vos informations pour déduire le contexte du pourquoi vous avez fait quelque chose et pourquoi vous avez choisi de le faire ainsi. Si les agents n'ont pas ces éléments comme preuves empiriques, ils ne pourront jamais faire les mêmes arbitrages que votre équipe pendant la planification ou l'idéation.
Andrej Karpathy a proposé un wiki LLM
En avril, Karpathy a proposé une couche persistante située entre les sources brutes et la récupération, où un modèle lit en continu ce qui arrive et le synthétise en un ensemble de pages interconnectées et navigables. Il l'a présentée pour la lecture personnelle, la recherche et l'usage en entreprise, signalant discrètement que la même mécanique fonctionnait à toute échelle.
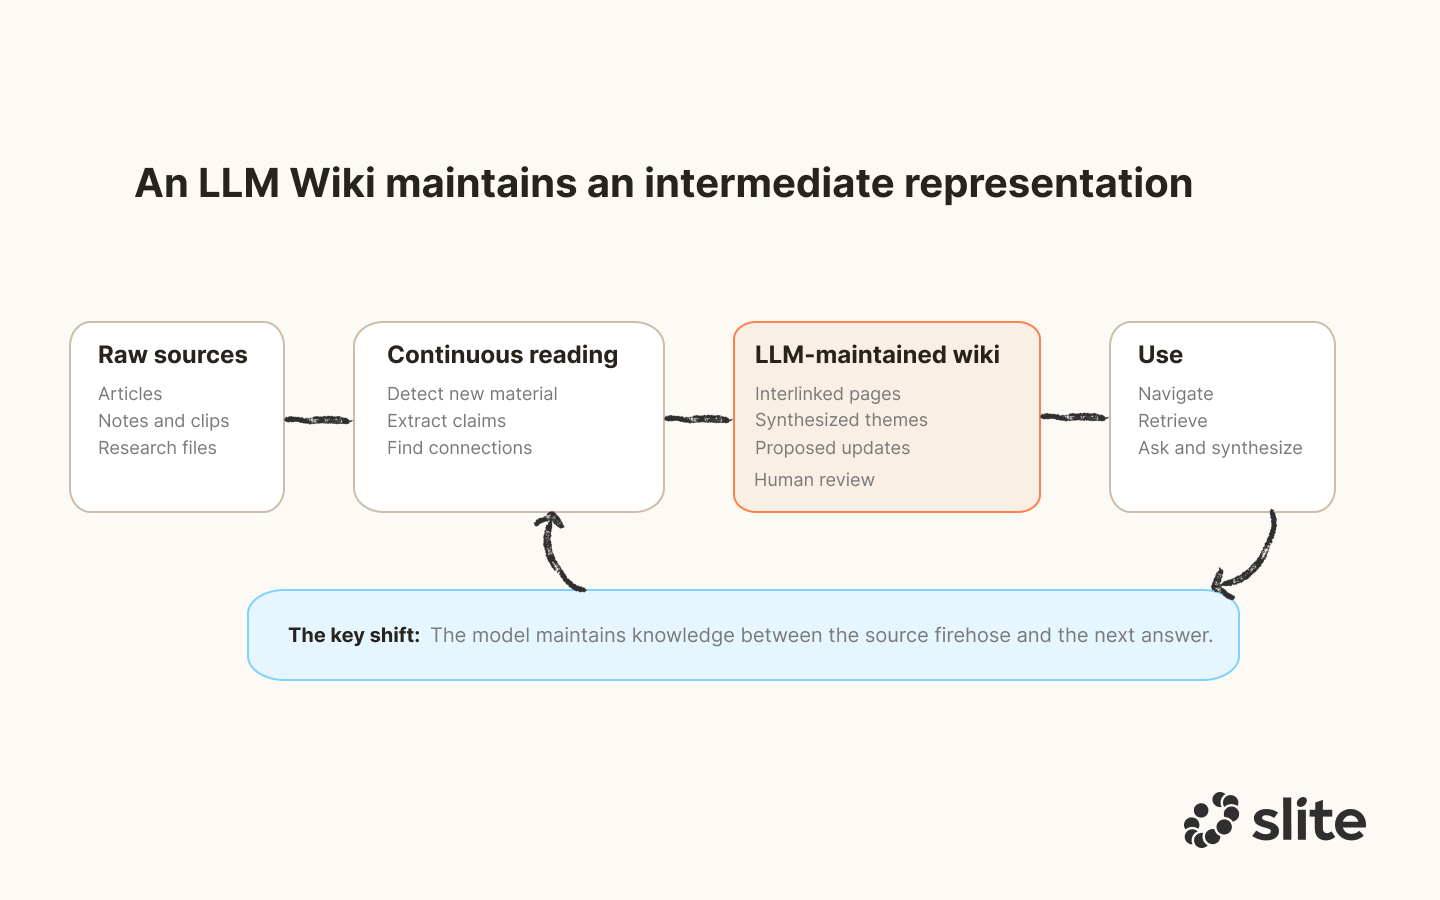
Cela a rendu une idée abstraite assez concrète pour construire dessus, et cela a suscité des expérimentations.
→ Pour aller plus loin : Base de connaissances LLM : comment en construire une qui fonctionne vraiment (2026)
Puis GBrain est arrivé
Garry Tan a construit GBrain pour servir ses propres agents, en lui fournissant réunions, e-mails et tout ce qui traversait sa journée, afin que les agents travaillant pour lui aient de quoi travailler. Il ingérait, enrichissait, consolidait et continuait pendant qu'il ne regardait pas.
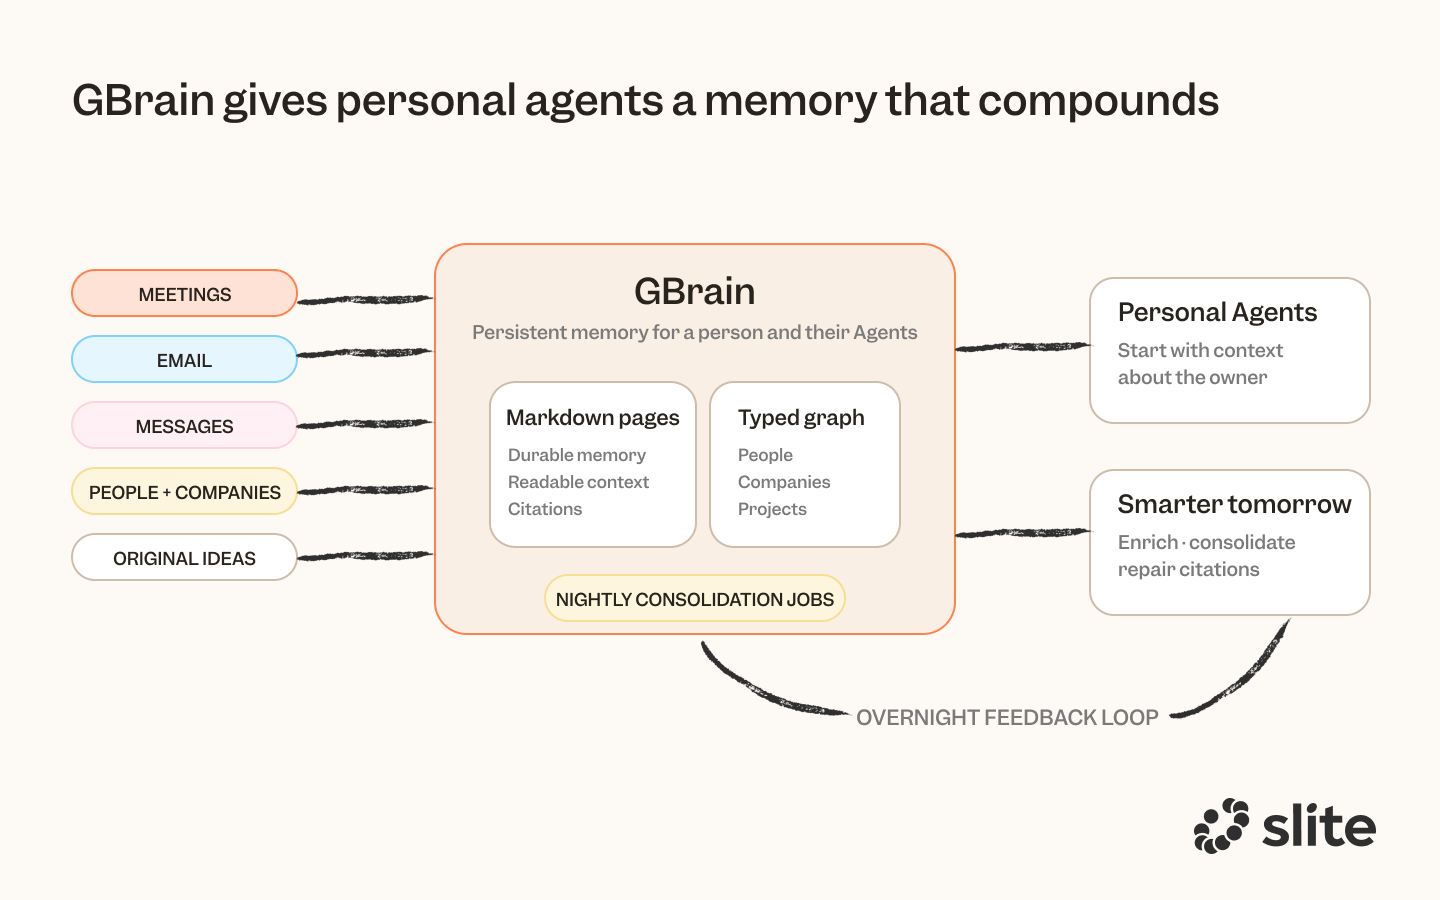
En tant qu'implémentation open source, il a transformé la mémoire persistante d'un individu et de ses agents en quelque chose qu'on pouvait lire, exécuter et discuter. Le projet s'est ensuite étendu pour couvrir les cas d'usage de company brain.
La RFS de YC a consolidé tout cela en un Company Brain
La Request for Startups de l'été 2026 de Y Combinator comprenait une entrée de Tom Blomfield intitulée Company Brain, qui citait GBrain directement et demandait « le G-Brain de Garry, mais pour chaque entreprise du monde ».
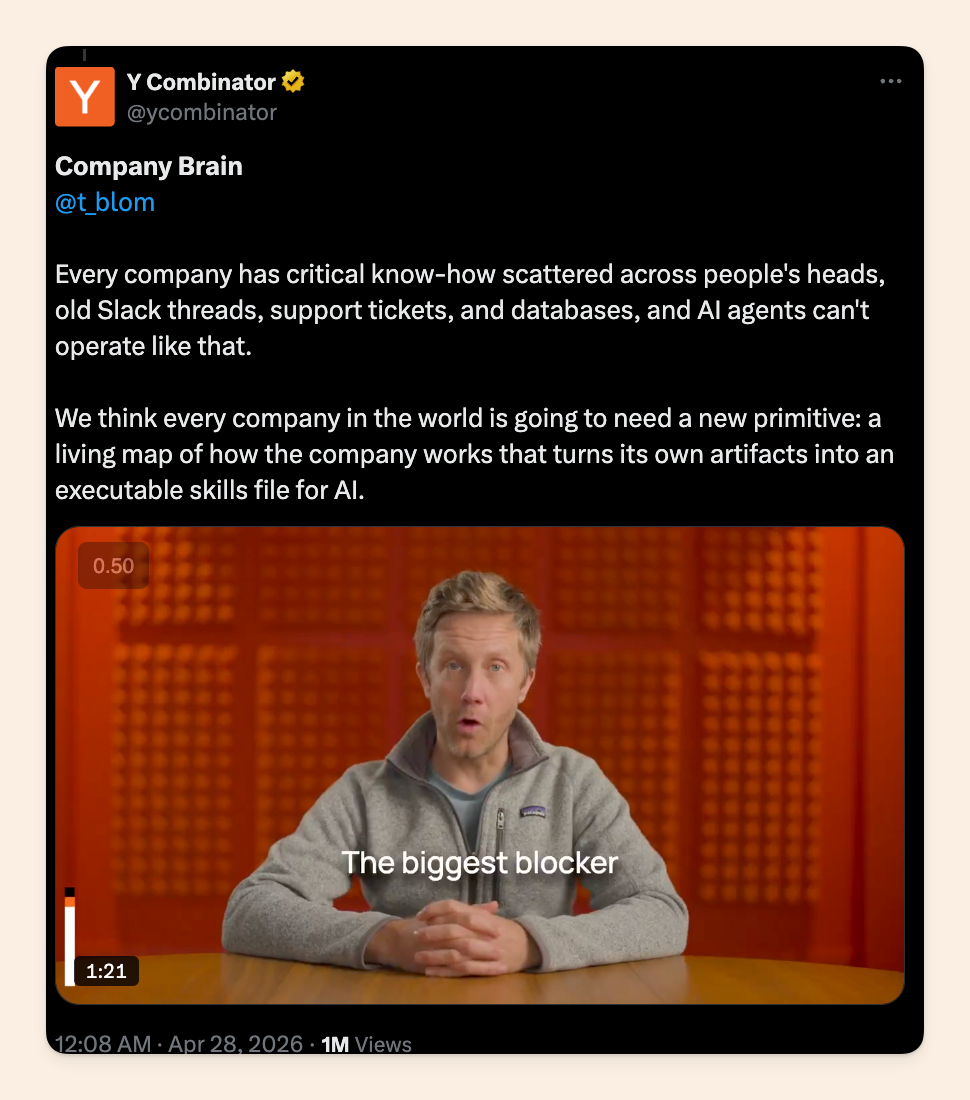
L'entrée disait aussi clairement ce que la catégorie n'est pas : une recherche d'entreprise, ou un chatbot greffé sur un wiki. Elle observait explicitement, et en déduisait à juste titre, qu'un Company Brain est une nouvelle catégorie avec ses propres défis, et qu'il faut des efforts dédiés pour le construire.
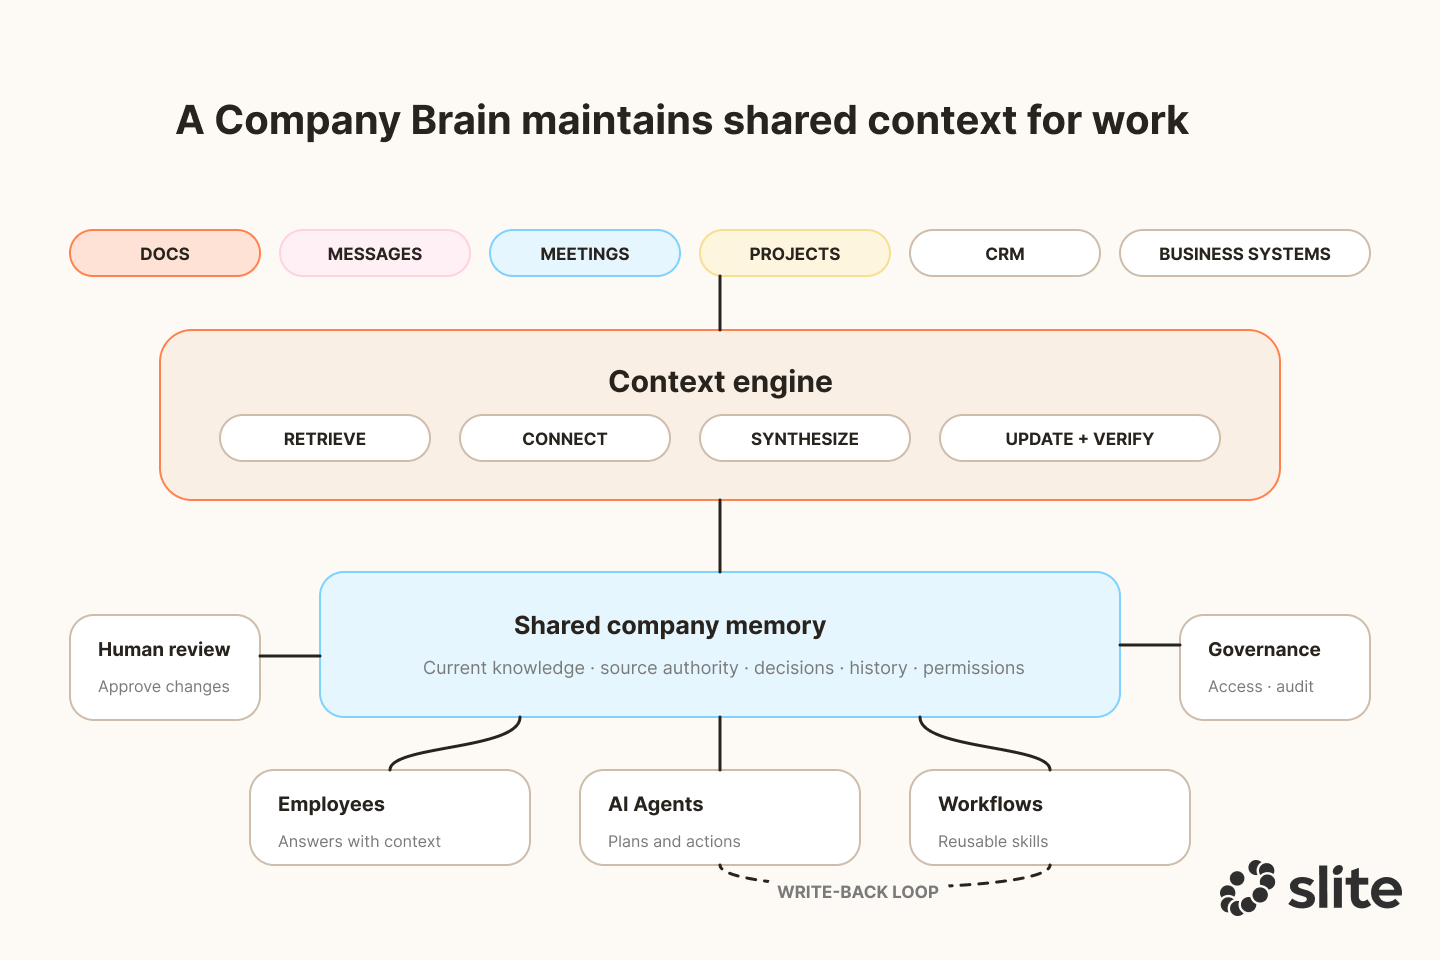
La mémoire personnelle a fourni l'ambition d'un système qui lit et synthétise à votre place.
La connaissance d'entreprise a fourni l'échelle et les problèmes peu glamour.
Le contexte des décisions a fourni la chose qui vaut la peine d'être stockée.
Les agents ont fourni le consommateur, la raison pour laquelle tout cela doit désormais être lisible par une machine et à jour, plutôt que simplement consultable.
Pourquoi tout le monde veut-il un brain ?
L'attrait vient de deux directions à la fois, il est donc utile de séparer ce que les entreprises veulent réellement de ce qui rend la version personnelle si excitante.
Ce que veulent les entreprises
Les entreprises veulent que le contexte persiste entre les sessions, se transmette aux nouveaux employés et aux agents, révèle les connexions entre équipes et reste utile sans que quelqu'un nettoie constamment une base de connaissances.
Tous ces besoins pointent vers le même résultat. Le contexte de l'entreprise doit persister, voyager et s'améliorer.
Pourquoi les brains personnels sont si excitants
Un brain personnel promet que tout ce que vous avez lu, écrit, regardé, surligné ou qui vous a brièvement obsédé peut être rassemblé et relié. Vous auriez enfin votre propre tour de Babel, chaque étage construit à partir de quelque chose que vous avez un jour consommé ou créé.
Il vous aide à vous souvenir, mais son attrait plus profond est de pouvoir vous voir de l'extérieur.
Jusqu'à récemment, construire cette structure impliquait de choisir des dossiers, d'ajouter des tags, de créer des liens et de maintenir le système vous-même. Les LLM ont changé la donne. Ils pouvaient lire ce que vous consommiez, le relier, le résumer et maintenir la structure à votre place.
Le second brain a cessé de ressembler à une habitude de classement et a commencé à ressembler à un logiciel capable de penser à vos côtés.
Là où brains personnels et Company Brains se séparent
Un Company Brain hérite de la promesse de mémoire persistante, puis la rend opérationnelle. Il doit cartographier ce qu'une organisation sait, briefer employés et agents, respecter les permissions, résoudre les sources contradictoires et tenir compte de décisions qui changent au fil du temps.
Avant de vous lancer dans un déploiement ou dans des top 10, il vaut la peine d'examiner les détails et de comprendre si vous voulez vraiment un company brain pour votre équipe ou si seul un brain personnel vous intéresse.
| Brain personnel | Company Brain | |
|---|---|---|
| À qui il appartient | Une personne | Une équipe ou une entreprise |
| Ce qu'il contient | Notes, lectures, idées, e-mails et fichiers personnels | Documents, conversations, réunions, projets, données clients et outils de l'entreprise |
| À quoi il sert | Mémoire, synthèse et connaissance de soi | Travail partagé, onboarding, décisions et automatisation |
| Qui décide de ce qui est vrai | Vous | Plusieurs propriétaires et sources |
| Qui peut y accéder | Généralement vous seul | Employés et agents avec des permissions différentes |
| Qui le maintient | Vos préférences et vos habitudes | Règles de l'entreprise, propriétaires et systèmes automatisés |
| Ce qui se passe quand il se trompe | Vous recevez une mauvaise réponse | Un contexte incorrect peut affecter tout un flux de travail |
| Ce qui compte le plus | Utilité personnelle | Exactitude, accès, gouvernance et confiance |
Si la connaissance vous appartient et qu'une erreur ne gêne que vous, vous voulez probablement un brain personnel.
Dès que ce contexte doit être partagé, soumis à des permissions, maintenu et digne de confiance pour d'autres personnes ou agents, vous construisez un Company Brain.
Lequel vous faut-il ?
Commencez par là où le contexte doit voyager.
Nous avons comparé dix vraies solutions de company brain, des dépôts open source aux produits managés, si vous voulez voir les options côte à côte.
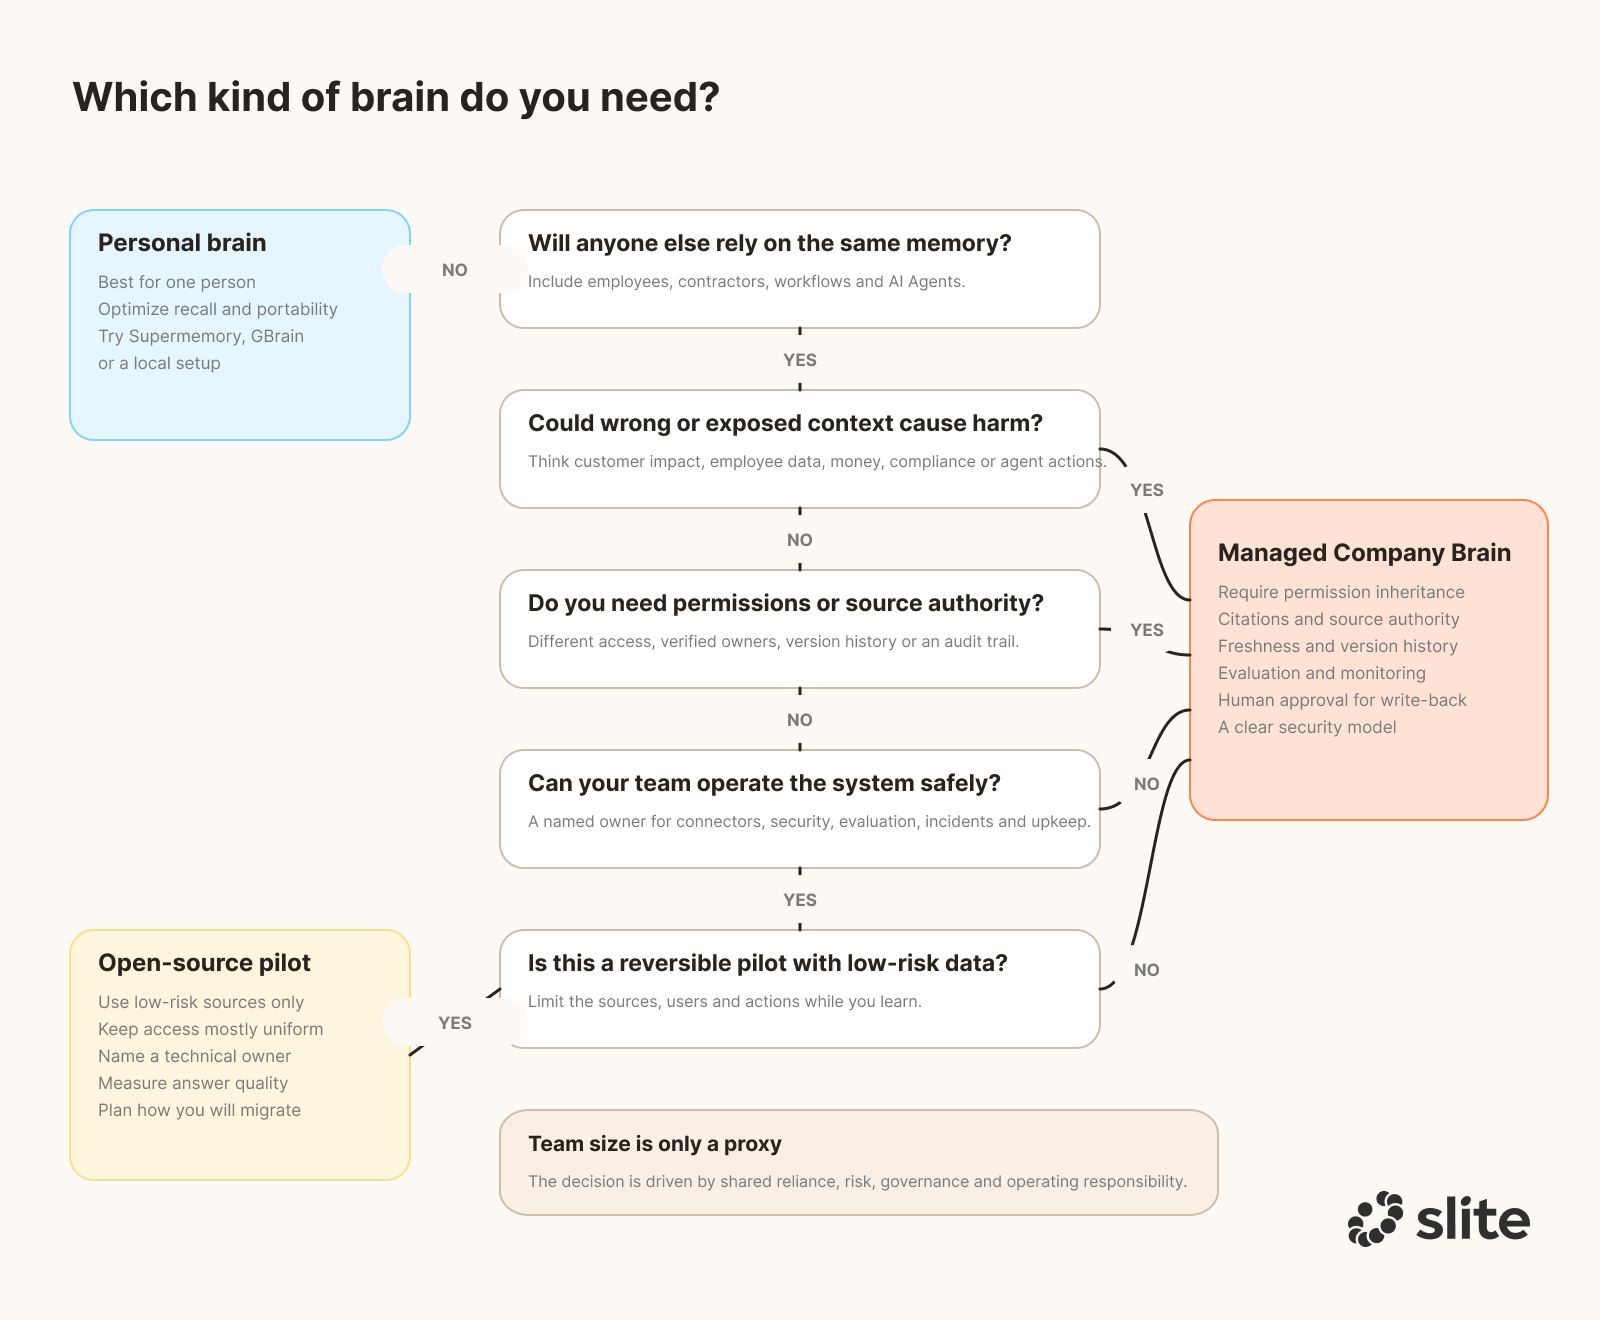
Choisissez un brain personnel quand la mémoire vous appartient
Si vous voulez relier vos notes, vos lectures, vos réunions et vos idées, commencez par un outil personnel.
Supermemory, GBrain et d'autres projets open source similaires peuvent vous aider à construire une mémoire persistante sans introduire de permissions ni de gouvernance à l'échelle de l'entreprise.
La principale question est de savoir si le système correspond à la façon dont vous consommez et créez l'information.
Envisagez l'open source pour une petite équipe soudée
Un Company Brain open source peut fonctionner quand votre équipe est petite, que la plupart des gens peuvent accéder aux mêmes informations et qu'une personne technique peut maintenir le système.
C'est une voie raisonnable pour une startup de dix personnes qui fonctionne comme une seule unité. Elle devient moins confortable quand des données clients, des informations sur les employés ou des niveaux d'accès différents entrent dans le système.
L'open source ne supprime pas le travail de sécurité et de maintenance. Il le transfère à votre équipe.
Choisissez un company brain managé quand le contexte devient de l'infrastructure
Un company brain dédié, comme Slite, est utile quand différentes personnes et différents agents ont besoin d'accès différents, que les sources se contredisent ou que la connaissance de l'entreprise doit rester à jour sans qu'un fondateur la maintienne.
Il devrait aussi devenir la norme quand le système traite des informations sensibles ou fournit du contexte à des agents capables d'agir.
Slite Agent est conçu pour cette voie. Il donne aux équipes un espace gouverné pour maintenir la connaissance de l'entreprise et la rendre disponible à la fois aux employés et aux agents.
Si vous cherchez à déployer quelque chose pour votre équipe en croissance, avec ces fondamentaux pris en charge dès le premier jour, réservez une démo pour en discuter avec nous.