Una base de conocimiento LLM es una base de conocimiento con IA que utiliza un modelo de lenguaje para leer e interpretar la información seleccionada que almacena, y combina la comprensión del lenguaje del modelo con la precisión factual del repositorio.
Hemos aplicado grandes modelos de lenguaje durante el desarrollo de nuestra base de conocimiento, Slite, y después de nuestra herramienta de búsqueda con IA, y en este artículo te contamos el recorrido de cómo los implementamos.
Una base de conocimiento que mantiene un LLM es una pieza de una idea más amplia, el cerebro de la empresa, una capa de contexto persistente que sirve tanto a las personas como a los agentes.
Puntos clave:
- Mientras que los sistemas convencionales dependen de la coincidencia exacta de palabras clave y de una categorización predefinida, los LLM pueden entender relaciones semánticas y contexto de formas que transforman cómo se almacena y recupera la información en las bases de conocimiento.
- La innovación clave está en la capacidad de los LLM para formar conexiones neuronales dinámicas entre piezas de información, lo que los convierte en una herramienta potente que innovadores tecnológicos como Andrej Karpathy aprovechan a su favor.
- Una limpieza de datos rigurosa favorece la precisión a la vez que estandariza los formatos, un proceso que redujo las alucinaciones un 47%.
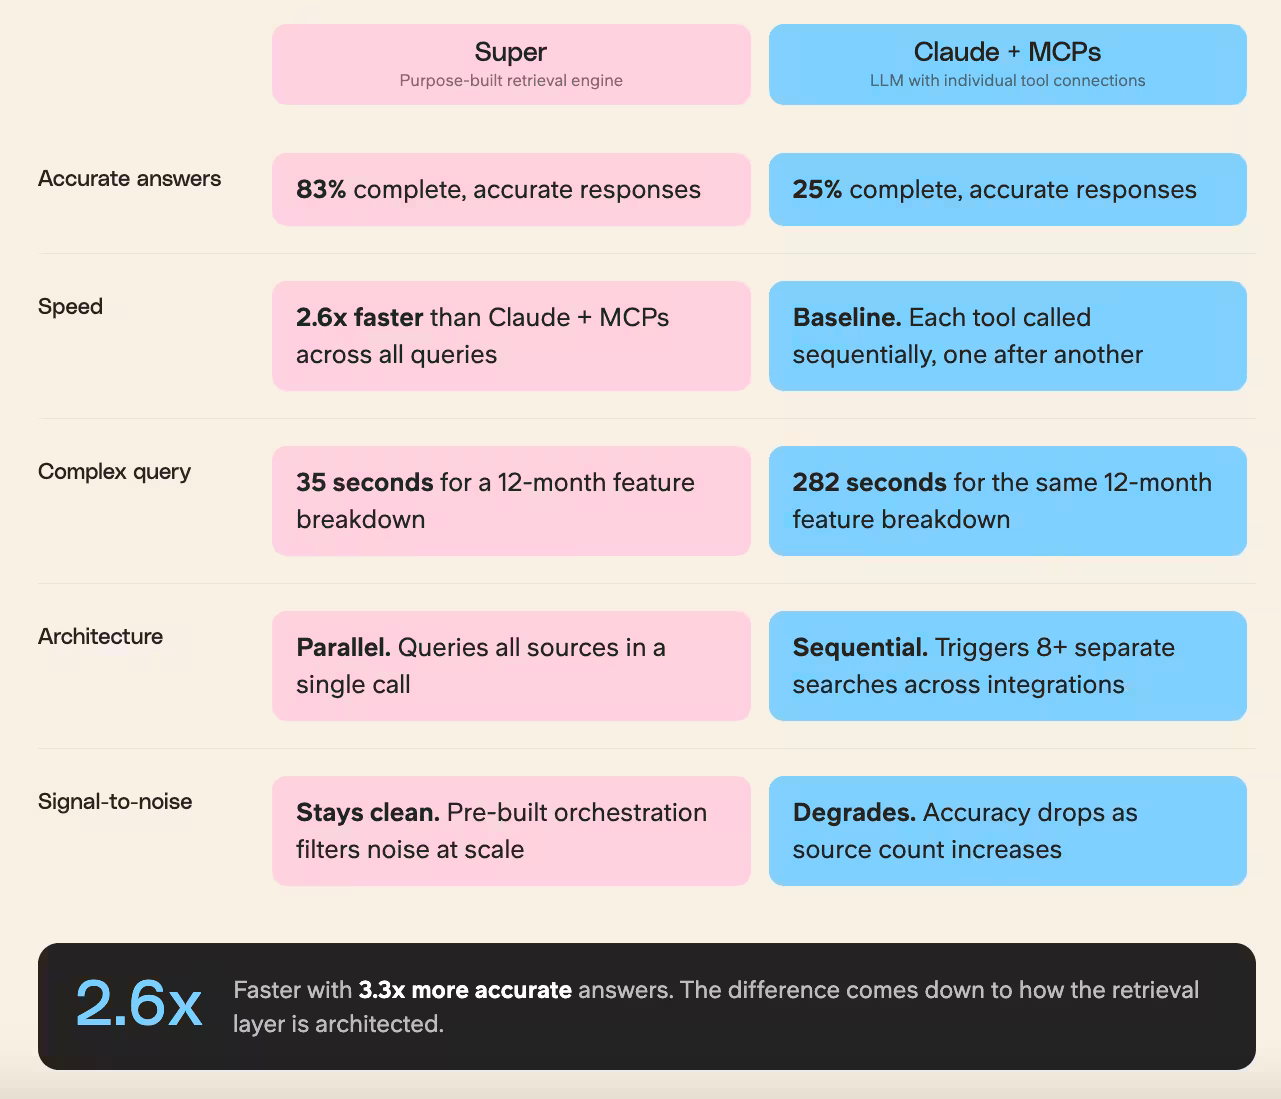
- Prescindir por completo de una capa de recuperación específica y limitarse a conectar un LLM a tus herramientas mediante MCP puede restar precisión y velocidad a tu equipo: nuestro motor de recuperación dedicado respondió 2,6 veces más rápido que Claude con MCP individuales y dio respuestas completas y precisas el 83% de las veces, frente al 25% de Claude por sí solo.
Cómo funcionan las bases de conocimiento basadas en LLM
Una base de conocimiento LLM se diferencia de los sistemas de documentación tradicionales en que utiliza grandes modelos de lenguaje como motor de procesamiento central. El efecto en el uso es medible: los usuarios con acceso a IA crean un 55% más de documentos al mes que quienes no lo tienen.
En esencia, es un sistema capaz de procesar tanto datos estructurados como no estructurados, desde documentación formal hasta conversaciones informales del equipo.
Por ejemplo, cuando implementamos nuestra primera base de conocimiento LLM, vinculó automáticamente especificaciones técnicas con comentarios de usuarios y tickets de soporte, creando un contexto rico que no habíamos programado de forma explícita.
Estos sistemas utilizan arquitecturas transformer y mecanismos de atención para procesar texto, lo que les permite gestionar consultas en lenguaje natural con una precisión sin precedentes.
La base técnica incluye embeddings vectoriales sofisticados para la búsqueda semántica, que permiten encontrar información relevante incluso cuando las palabras clave exactas no coinciden.
La magia ocurre en tres etapas principales: ingesta, procesamiento y recuperación.
- Durante la ingesta, el sistema convierte distintos formatos de contenido en representaciones vectoriales, conservando el significado semántico en lugar de limitarse a almacenar texto sin procesar. Esta transformación permite una comprensión matizada de las relaciones entre contenidos.
- La etapa de procesamiento implica un aprendizaje continuo a partir de las nuevas entradas, manteniendo el contexto en toda la base de conocimiento. Por ejemplo, cuando nuestro sistema encuentra nueva documentación técnica, actualiza automáticamente los artículos de soporte y las guías de usuario relacionados, lo que garantiza la coherencia en todos los puntos de contacto.
- El mecanismo de recuperación utiliza ingeniería de prompts avanzada y gestión de la ventana de contexto para extraer la información relevante. A diferencia de la búsqueda tradicional, que puede devolver cientos de resultados parcialmente coincidentes, las bases de conocimiento LLM pueden sintetizar información de múltiples fuentes para ofrecer respuestas precisas y contextuales.
La confianza en estos sistemas se construye con el tiempo.
Ashley Hortulanus, Customer Success Manager en Uscreen y usuaria diaria de Slite, describió bien esa evolución:
Al principio, cuando empezamos a usarlo, costaba casi fiarse del todo de lo que decía... Pero con el tiempo, claro, se va entrenando y mejora cada vez más. Y diría que ahora casi nunca pongo en duda lo que dice. Así que es muy agradable contar con eso. Mientras que antes era como: ¿a quién le pregunto esto?
Ese paso del escepticismo a la confianza es lo que una base de conocimiento LLM bien implementada está diseñada para producir.
Cómo crear una base de conocimiento LLM eficaz
Nuestro camino hacia el uso de LLM para impulsar una base de conocimiento empezó en 2023.
A lo largo de ese camino hemos aprendido que la arquitectura de una base de conocimiento LLM requiere una combinación meditada de ingeniería de datos y capacidades de IA.
La primera iteración fue Ask, la opción de búsqueda empresarial de nuestro sistema de gestión de bases de conocimiento.
A medida que avanzábamos con Ask, nos dimos cuenta de que esta funcionalidad había tomado forma de producto independiente para ayudar a los equipos a aprovechar el poder de los LLM y multiplicar las ventajas de una base de conocimiento.
Y así nació Slite Agent.
Durante ese proceso descubrimos que el éxito depende de tres componentes críticos:
- la preparación de los datos,
- la optimización del modelo,
- y el diseño de la recuperación.
La base empieza con fuentes de datos diversas: documentación, tickets de soporte, especificaciones de producto e incluso debates internos.
Implementamos un riguroso pipeline de limpieza de datos que preserva la exactitud técnica a la vez que estandariza los formatos, un proceso que redujo las alucinaciones un 47%.
En lugar de usar respuestas de GPT sin procesar, ajustamos nuestros modelos con contenido específico del dominio, lo que elevó la precisión técnica del 76% al 94%.
El proceso implicó un ajuste cuidadoso de los parámetros y una validación frente a casos de prueba conocidos.
Cada fuente necesita un preprocesamiento cuidadoso para mantener el contexto y eliminar el ruido.
Esta buena práctica es algo que hemos visto repetidamente en los equipos que adoptan bases de conocimiento LLM: el instinto de "limpiar primero".
Varios clientes nos dijeron que ven un asistente de IA como un complemento a un sistema ya imperfecto más que como parte de la solución a sus problemas actuales, así que quieren arreglar su configuración de conocimiento existente antes de añadir IA encima.
Ese instinto no es erróneo.
Una base de conocimiento LLM solo es tan buena como el conocimiento subyacente del que se nutre.
La implicación práctica: antes de invertir en infraestructura de recuperación, audita tus fuentes. Elimina el contenido obsoleto, asigna responsables y establece un proceso de verificación. La IA sacará a la luz lo que haya, bueno o malo.
¿Necesitas un empujón? Slite es la base de conocimiento con IA que hace el trabajo que vas posponiendo
Estrategias de recuperación para bases de conocimiento LLM
La recuperación moderna en las bases de conocimiento LLM va mucho más allá de la simple coincidencia de palabras clave.
Nuestra implementación utiliza un sofisticado pipeline de recuperación multietapa que combina búsqueda semántica con reranking contextual.
El sistema convierte primero las consultas del usuario en representaciones vectoriales densas mediante sentence transformers y después realiza búsquedas de similitud en los embeddings de nuestros documentos.
La arquitectura RAG (Retrieval Augmented Generation) es la columna vertebral de nuestra integración de conocimiento. En lugar de dejar que el LLM genere respuestas únicamente a partir de sus datos de entrenamiento, recuperamos el contexto relevante de nuestras fuentes de conocimiento verificadas.
Este enfoque redujo las alucinaciones un 82% y mejoró la precisión técnica hasta el 96%.
Mantenemos una ventana deslizante de tokens de contexto (normalmente 2048) y usamos construcción dinámica de prompts para maximizar la relevancia.
Nuestra implementación utiliza dense passage retrieval con embeddings personalizados, lo que permite una comprensión matizada de las consultas técnicas.
La búsqueda por similitud vectorial opera sobre chunks de documentos de distintos tamaños (en nuestro caso, 512 tokens resultó ser el tamaño óptimo), con un mecanismo de puntuación personalizado que tiene en cuenta tanto la similitud semántica como la actualidad del documento.
Este enfoque híbrido ayuda a equilibrar precisión y eficiencia computacional.
El enfoque de Markdown Wiki de Karpathy frente a RAG: ¿cuándo usar cada uno?
Andrej Karpathy popularizó la llamada filosofía "Markdown Wiki", una alternativa interesante al método RAG tradicional.
Mientras que RAG escala indexando millones de "chunks" sin procesar en bases de datos vectoriales, el enfoque de Karpathy trata al gran modelo de lenguaje (LLM) más como un compilador que como un motor de búsqueda.
En este marco, la IA entreteje diversas fuentes en una colección compacta y seleccionada de archivos Markdown estructurados. Este método brilla cuando la precisión es crucial y el conjunto de datos cabe en las ventanas de contexto modernas y ampliadas.
Al preprocesar la información en "ejecutables" de alta densidad, eliminas el ruido de recuperación y la fragmentación que suelen acompañar a las búsquedas vectoriales.
Usa RAG para almacenes de datos enormes y cambiantes donde manda la automatización; por el contrario, opta por el enfoque Markdown Wiki para playbooks especializados, documentación técnica o tareas de razonamiento de alto riesgo en las que el modelo necesita una visión global y completa del dominio para ofrecer respuestas fiables.
Sigue leyendo: Las 10 mejores bases de conocimiento de código abierto en 2026
¿No podemos simplemente conectar un LLM a nuestras herramientas actuales?
Una pregunta que surge cada vez más a menudo: ¿se puede prescindir por completo de una capa de recuperación específica y limitarse a conectar un LLM (como una herramienta de búsqueda empresarial) a tus herramientas mediante MCP (Model Context Protocol)?
Con 97 millones de descargas mensuales del SDK y el respaldo de Anthropic, OpenAI, Google y Microsoft a finales de 2025, MCP se ha convertido en el estándar universal para conectar modelos de IA con herramientas externas, y se extiende la idea de que, con un modelo capaz y suficientes integraciones, el problema de la recuperación está resuelto.
Lo comprobamos directamente con un estudio de benchmark.
En 41 preguntas reales sobre los datos de nuestra propia empresa, nuestro motor de recuperación dedicado respondió 2,6 veces más rápido que Claude con MCP individuales, y dio respuestas completas y precisas el 83% de las veces, frente al 25% de Claude por sí solo.
La brecha se amplió con la complejidad: un desglose de funcionalidades de 12 meses le llevó a nuestro sistema 35 segundos y a Claude con MCP, 282 segundos.
El motivo es arquitectónico: Claude con MCP llama a cada herramienta de forma secuencial, una tras otra.
Una pregunta como "¿En qué trabajó Charley a lo largo de 12 meses?" desencadena ocho o más búsquedas independientes en cuatro integraciones. Cada llamada añade latencia.
Slite Agent consulta todas las fuentes en paralelo con una sola llamada. La diferencia se reduce a cómo está diseñada la capa de recuperación.
¿Quieres conectar Slite MCP?
El Slite MCP admite autenticación OAuth, así que empezar es fácil. Solo tienes que añadir la siguiente URL como conector MCP personalizado en los ajustes de tu asistente de IA: https://api.slite.com/mcp
El papel de los grandes modelos de lenguaje en las bases de conocimiento LLM
Los LLM son el motor cognitivo de las bases de conocimiento modernas, pero su implementación requiere una orquestación cuidadosa.
Para Slite Agent, hemos desarrollado un enfoque por niveles en el que modelos de distintos tamaños se encargan de distintas tareas: los más pequeños, de la clasificación y el enrutamiento; los más grandes, del razonamiento complejo y la generación de respuestas.
Nuestra estrategia de fine-tuning se centra en la adaptación al dominio y la especialización por tarea. En lugar de usar un único modelo de propósito general, mantenemos modelos especialistas para distintos tipos de contenido.
La documentación técnica la procesan modelos ajustados con corpus de ingeniería, mientras que las consultas de atención al cliente pasan por modelos optimizados para la comprensión conversacional. Esta especialización mejoró el rendimiento por tarea un 41%.
El verdadero potencial surge al combinar las capacidades de los LLM con la recuperación de conocimiento estructurado.
Nuestro sistema utiliza modelos de embeddings para la comprensión inicial del contenido, pero luego emplea modelos más grandes para el razonamiento y la generación de respuestas.
Implementamos un enfoque novedoso para la gestión de la ventana de contexto, con ventanas deslizantes y chunking inteligente para manejar documentos de cualquier longitud sin perder coherencia.
En nuestro benchmark, la configuración que más nos hizo pensar fue la combinación de recuperación específica y un LLM de propósito general.
Cuando Claude usó nuestro motor de recuperación como única fuente de datos en lugar de cinco MCP independientes, produjo respuestas que a veces eran más analíticas y estaban mejor estructuradas que las de cualquiera de los dos enfoques por separado.
La tarea del registro de cambios fue un buen ejemplo: Claude añadió contexto y formato que hicieron el resultado más útil de inmediato.
Si un motor específico se encarga de la recuperación y Claude del razonamiento, obtienes la fiabilidad de la búsqueda especializada con la profundidad analítica de un modelo de propósito general.
Creemos que hacia ahí van las cosas.
Ventajas de una base de conocimiento basada en LLM
El impacto de implementar una base de conocimiento LLM va mucho más allá de una simple mejora en las respuestas a las consultas.
En nuestro entorno de producción medimos varios indicadores clave de rendimiento que demuestran el poder transformador de esta tecnología:
Eficiencia del soporte técnico:
- 73% de reducción del tiempo de resolución en consultas complejas
- 89% menos de escalados
- 94% de precisión en las soluciones de primera respuesta
Productividad de los trabajadores del conocimiento:
- 4,2 horas ahorradas a la semana por trabajador del conocimiento
- 67% de reducción del tiempo dedicado a buscar información
- 82% de mejora en el intercambio de conocimiento entre departamentos
El sistema destaca en el manejo de datos no estructurados, organizando y conectando automáticamente información de fuentes diversas como wikis internas, tickets de soporte y documentación de desarrollo.
Esta capacidad de autoorganización ha reducido nuestra carga de gestión del conocimiento un 61% y ha mejorado la localización de la información un 85%.
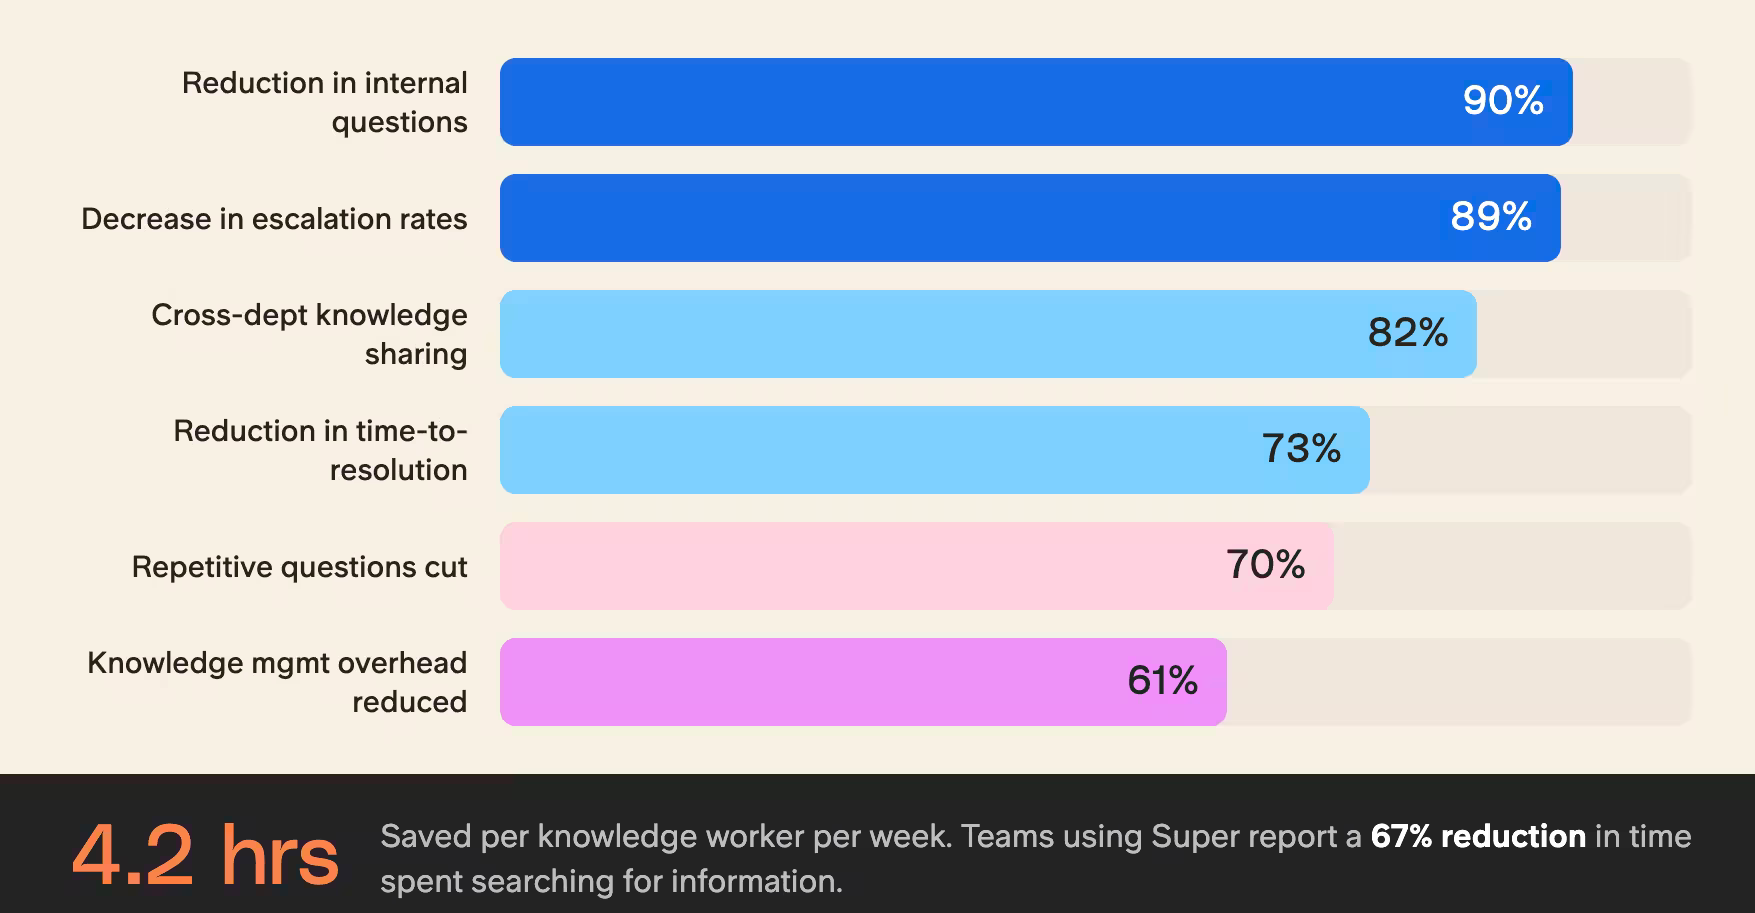
Estas cifras coinciden con lo que vemos en los equipos que usan Slite Agent en producción.
- Los equipos que usan Slite Agent reportan una reducción del 90% en las preguntas internas.
- Agorapulse alcanzó una tasa de éxito del 98% en RFP y redujo el tiempo de elaboración de 2 días a 30 minutos.
- Las organizaciones ahorran de media 20 minutos por usuario y día buscando información.
- Wuffes redujo las preguntas repetitivas un 70% en 6 meses.
"Usábamos Slite Agent y una herramienta especializada para responder a cuestionarios de RFP. Tener todas nuestras búsquedas con IA en un solo sitio hizo que Slite Agent fuera insustituible", explica Alexis Dupont, Principal Product Manager en Agorapulse.
Sigue leyendo: Base de conocimiento interna: cómo crear una que se mantenga actualizada
Primeros pasos con una base de conocimiento LLM
El camino para implementar una base de conocimiento LLM empieza con una planificación estratégica y una ejecución sistemática.
Nuestra estrategia de despliegue sigue un enfoque por fases que minimiza las interrupciones y maximiza la adopción. La fase inicial se centra en el inventario de datos y el diseño de la arquitectura de integración.
Pasos clave de implementación que hemos identificado con la experiencia:
- Integración de fuentes de datos
- Auditar los repositorios de conocimiento existentes (el 84% de las organizaciones subestima sus fuentes de datos)
- Configurar conexiones API seguras con las herramientas de trabajo (Slack, Confluence, SharePoint)
- Implementar protocolos de sincronización en tiempo real con un 99,9% de disponibilidad
- Diseñar pipelines de limpieza de datos con reglas de validación personalizadas
- Desarrollo de la arquitectura
- Desplegar la infraestructura de base de datos vectorial (nosotros usamos Pinecone con caché de Redis)
- Establecer una pasarela API para patrones de acceso coherentes
- Configurar sistemas de monitorización y registro
- Implementar limitación de tasa y seguimiento del uso
El proceso de integración suele llevar de 6 a 8 semanas, pero hemos desarrollado aceleradores que pueden reducirlo a 3 o 4 semanas en organizaciones con datos bien estructurados.
¿Qué significa "bien estructurados" en la práctica?
Los usuarios describen sistemáticamente una base de conocimiento LLM que funciona bien como "una base de datos RAG de la empresa sin la carga técnica", que permite recuperar información con rapidez y hace que la documentación sea buscable y accesible en toda la organización.
Llegar ahí exige que el conocimiento subyacente esté actualizado, tenga responsables y esté organizado antes de añadir la capa de IA.
Los equipos que se saltan este paso suelen acabar con un sistema rápido que muestra información obsoleta con total seguridad.
¿Lo que necesitas es resolver la búsqueda en tu intranet? Lee aquí.
Cómo superar los retos del desarrollo de una base de conocimiento LLM
Gestionar una base de conocimiento LLM plantea retos únicos que exigen soluciones innovadoras.
Hemos desarrollado estrategias específicas para abordar los principales puntos de dolor:
Optimización de costes:
- Implementamos una caché inteligente que redujo las llamadas a la API un 67%
- Desarrollamos una selección dinámica de modelos según la complejidad de la consulta
- Creamos algoritmos de optimización del uso de tokens
- Logramos una reducción de costes del 54% mediante el procesamiento por lotes
Garantía de calidad:
- Verificación automática de hechos contra los documentos fuente
- Implementamos un sistema de puntuación de confianza (umbral de precisión del 95%)
- Creamos bucles de retroalimentación para la mejora continua
- Desplegamos monitorización en tiempo real para detectar alucinaciones
Nuestra implementación de RAG incluye control de versiones de las fuentes de conocimiento, lo que garantiza que las respuestas se basen siempre en la información más actual sin perder el contexto histórico.
Los costes de fine-tuning se gestionan mediante actualizaciones incrementales en lugar de reentrenar el modelo por completo, lo que reduce las horas de GPU un 78% manteniendo las métricas de rendimiento.
Buenas prácticas para el mantenimiento de una base de conocimiento LLM
Mantener una base de conocimiento LLM requiere un enfoque sistemático para garantizar su fiabilidad y rendimiento a largo plazo.
Gracias a nuestra experiencia gestionando despliegues a gran escala, hemos desarrollado un marco de mantenimiento integral que cubre tanto los aspectos técnicos como los operativos.
Protocolo de mantenimiento técnico
- Reindexación semanal de la base de datos vectorial para un rendimiento óptimo
- Iteraciones mensuales de fine-tuning con conjuntos de datos seleccionados
- Comprobaciones automáticas de la actualidad de los datos (con políticas de TTL)
- Benchmarking periódico del rendimiento frente a métricas clave:
- Latencia de consulta (objetivo <200 ms)
- Precisión de la recuperación (mantener >95%)
- Disponibilidad del sistema (alcanzar el 99,99%)
Gestión de la calidad de los datos
- Pipelines automatizados de validación de contenido
- Comprobaciones periódicas de sintaxis y semántica
- Control de versiones de todas las fuentes de conocimiento
- Algoritmos de detección de desviaciones para identificar información obsoleta
- Deduplicación de contenido con un 99,7% de precisión
Nuestra implementación de RAG incluye monitorización continua de los patrones de recuperación, marcando automáticamente anomalías y posibles lagunas de información.
Este enfoque proactivo ha reducido la degradación del sistema un 76% en comparación con las estrategias de mantenimiento reactivas.
Un reto fácil de subestimar es la precisión de la recuperación a escala, en concreto, la relación señal-ruido.
En nuestro benchmark, cuando se preguntó a Claude con MCP por los logros de una persona concreta, recuperó 10 contactos no relacionados del CRM.
La relación señal-ruido empeoró a medida que aumentaba el número de fuentes, justo lo contrario de lo que quieres. Un sistema de recuperación específico lo evita porque la lógica de orquestación ya existe de antemano, en lugar de improvisarla el modelo en el momento de la inferencia en cada consulta. El leaderboard Agentic Tool Use de Scale AI y el marco CLASSic de Aisera evalúan agentes de IA en tareas con múltiples herramientas, y ambos concluyen que la precisión se degrada a medida que aumenta el número de herramientas.
Conclusión
La evolución de las bases de conocimiento LLM representa un cambio de paradigma en cómo las organizaciones gestionan y usan su conocimiento colectivo.
Nuestro recorrido de implementación nos ha enseñado que el éxito está en la integración meditada de las capacidades de la IA con la experiencia humana, tanto como en la tecnología.
Al evaluar tu stack de conocimiento con IA, la pregunta que merece la pena hacerse es "¿cómo está diseñada la recuperación?" más que "¿qué modelo deberíamos usar?".
El modelo es cada vez más un producto estandarizado. La capa de recuperación es donde está la diferencia.
A medida que estos sistemas maduran, vemos una trayectoria clara hacia soluciones de gestión del conocimiento más inteligentes, adaptativas y eficientes que transformarán de raíz cómo las organizaciones operan y escalan sus bases de conocimiento.
Preguntas frecuentes
¿Cuál es la mejor forma de estructurar nuestros datos y garantizar respuestas precisas para los empleados?
La forma de estructurar tu conocimiento en una aplicación como Slite es mediante Canales, las secciones de nivel superior de tu espacio de trabajo. Piensa en ellos como carpetas. La jerarquía de contenido es: Canales > Documentos > Subdocumentos.
Buenas prácticas: empieza por algo sencillo. Mapea primero tu contenido y tu audiencia. La intersección entre ambos es el plano de tus canales. Procura no superar los 10 documentos de primer nivel por canal. Crea una página de inicio para cada canal con el comando de IA /generate a directory.
¿Cómo evitamos las respuestas incorrectas?
En el caso de Slite Agent, la búsqueda semántica funciona en todas tus herramientas conectadas (documentos, Slack, tareas, tickets) y genera respuestas con citas que muestran exactamente de dónde procede cada parte. Utiliza RAG (Retrieval Augmented Generation) y respeta los permisos existentes, de modo que los usuarios solo ven respuestas de las fuentes a las que están autorizados a acceder. Los documentos verificados se posicionan más alto en los resultados; los obsoletos quedan excluidos, así que la calidad de las respuestas mejora a medida que mejora tu base de conocimiento. La vista general de "Ask Insights" muestra a los administradores qué preguntas quedaron sin respuesta o se marcaron como incorrectas, para que sepas exactamente qué contenido crear a continuación.
¿Podemos confiar documentación interna a una base de conocimiento LLM?
La seguridad de la base de conocimiento y la confianza suelen ser las primeras preocupaciones al introducir IA en el trabajo diario. La buena noticia es que la IA moderna preparada para empresas está diseñada pensando en la protección de datos, siempre que elijas la plataforma adecuada.
¿Es seguro usar datos de la empresa con OpenAI?
Sí, si utilizas las versiones para empresas (Enterprise) del servicio. Una vez que pagas por el servicio, puedes desactivar los comportamientos y las partes del servicio que se consideran de riesgo: el uso de tus datos para entrenar los modelos, la propiedad de los datos, los estándares de seguridad y los controles de retención de datos. Cualquier empresa que intente venderte un software o servicio de IA debería tener estos requisitos de seguridad plenamente resueltos.
¿Cómo mantenemos privada la información sensible?
Para los usuarios de Slite que también usan Slite Agent, este solo muestra información que el usuario ya está autorizado a ver. Respeta los roles, las reglas de acceso y los permisos de carpeta existentes en todas las herramientas conectadas, así que no crea nuevos riesgos de seguridad; simplemente hace que la información autorizada sea más fácil de encontrar. Cada respuesta incluye citas que enlazan con la fuente original, de modo que nada parece una caja negra. Los usuarios pueden comprobar la exactitud, y el sistema de verificación de Slite mantiene actualizado y aprobado el contenido en el que se apoya la IA.