Eine LLM-Wissensdatenbank, also eine LLM-gestützte Wissensdatenbank (KI-Wissensdatenbank), nutzt ein LLM, um die kuratierten Informationen in der Wissensdatenbank zu lesen und zu interpretieren. So verbindet sie das Sprachverständnis des Modells mit der faktischen Genauigkeit des Datenbestands.
Wir haben große Sprachmodelle bei der Entwicklung unserer Wissensdatenbank Slite und anschließend unseres KI-Suchtools eingesetzt. In diesem Artikel nehmen wir Sie mit auf den Weg, wie wir sie implementiert haben.
Eine Wissensdatenbank, die ein LLM pflegt, ist ein Baustein einer größeren Idee: des Company Brain, einer dauerhaften Kontextschicht, die sowohl Menschen als auch Agenten bedient.
Das Wichtigste in Kürze:
- Während herkömmliche Systeme auf exakter Schlüsselwortübereinstimmung und vordefinierten Kategorien beruhen, können LLMs semantische Zusammenhänge und Kontext verstehen, und zwar auf eine Weise, die grundlegend verändert, wie Informationen in Wissensdatenbanken gespeichert und abgerufen werden.
- Die zentrale Neuerung liegt in der Fähigkeit von LLMs, dynamische neuronale Verbindungen zwischen einzelnen Informationen herzustellen. Das macht sie zu einem mächtigen Werkzeug, das Tech-Vordenker wie Andrej Karpathy gezielt für sich nutzen.
- Rigorose Datenbereinigung verbessert die Genauigkeit und vereinheitlicht zugleich die Formate, ein Prozess, der Halluzinationen um 47 % reduziert hat.
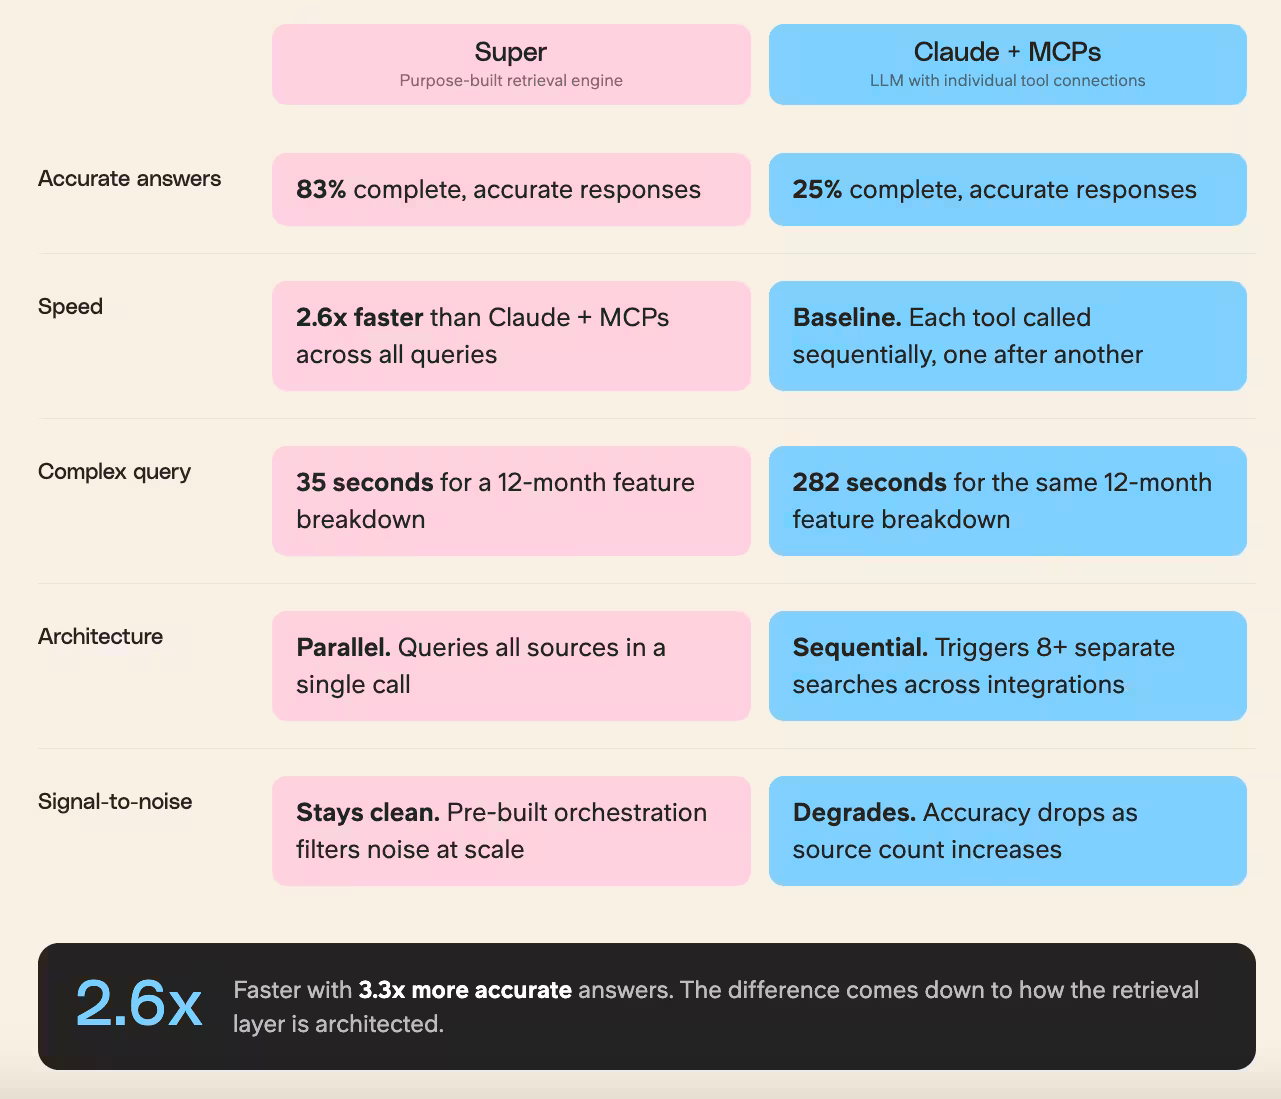
- Wer eine eigens entwickelte Retrieval-Schicht komplett überspringt und ein LLM per MCP einfach mit seinen Tools verdrahtet, bringt sein Team um Genauigkeit und Geschwindigkeit: Unsere dedizierte Retrieval-Engine antwortete 2,6-mal schneller als Claude mit einzelnen MCPs und lieferte in 83 % der Fälle vollständige, korrekte Antworten, gegenüber 25 % bei Claude allein.
Wie LLM-gestützte Wissensdatenbanken funktionieren
Eine LLM-Wissensdatenbank unterscheidet sich grundlegend von herkömmlichen Dokumentationssystemen, weil sie große Sprachmodelle als zentrale Verarbeitungs-Engine nutzt. Der Effekt auf die Nutzung ist messbar: Nutzer mit KI-Zugang erstellen 55 % mehr Dokumente pro Monat als Nutzer ohne.
Im Kern ist sie ein System, das sowohl strukturierte als auch unstrukturierte Daten verarbeiten kann, von formaler Dokumentation bis hin zu lockeren Teamgesprächen.
Als wir zum Beispiel unsere erste LLM-Wissensdatenbank implementierten, verknüpfte sie automatisch technische Spezifikationen mit Nutzerfeedback und Support-Tickets und schuf so einen reichen Kontext, den wir nie explizit programmiert hatten.
Diese Systeme verarbeiten Text mit Transformer-Architekturen und Attention-Mechanismen und können dadurch natürlichsprachliche Anfragen mit bislang unerreichter Genauigkeit beantworten.
Das technische Fundament umfasst ausgefeilte Vektor-Embeddings für die semantische Suche, sodass relevante Informationen auch dann gefunden werden, wenn die exakten Schlüsselwörter nicht übereinstimmen.
Die Magie passiert in drei Hauptphasen: Ingestion, Verarbeitung und Retrieval.
- Bei der Ingestion wandelt das System verschiedene Inhaltsformate in Vektorrepräsentationen um und bewahrt dabei die semantische Bedeutung, statt nur Rohtext zu speichern. Diese Transformation ermöglicht ein nuanciertes Verständnis der Beziehungen zwischen Inhalten.
- Die Verarbeitungsphase umfasst kontinuierliches Lernen aus neuen Eingaben bei gleichzeitiger Wahrung des Kontexts über die gesamte Wissensdatenbank hinweg. Stößt unser System etwa auf neue technische Dokumentation, aktualisiert es automatisch die zugehörigen Support-Artikel und Nutzerhandbücher und sorgt so für Konsistenz an allen Kontaktpunkten.
- Der Retrieval-Mechanismus nutzt fortgeschrittenes Prompt Engineering und Kontextfenster-Management, um relevante Informationen abzurufen. Anders als eine herkömmliche Suche, die Hunderte teilweise passender Treffer zurückgibt, können LLM-Wissensdatenbanken Informationen aus mehreren Quellen zu präzisen, kontextbezogenen Antworten zusammenführen.
Das Vertrauen in diese Systeme wächst mit der Zeit.
Ashley Hortulanus, Customer Success Managerin bei Uscreen, die Slite täglich nutzt, hat diesen Verlauf treffend beschrieben:
Am Anfang, als wir es einzusetzen begannen, fiel es schwer, dem, was gesagt wurde, wirklich zu vertrauen... Aber mit der Zeit wird es natürlich trainiert und wird immer besser. Und ich würde sagen, heute hinterfrage ich kaum noch, was gesagt wird. Das ist wirklich angenehm, das einfach zu haben. Vorher hieß es eher: Oh, an wen wende ich mich mit dieser Frage?
Der Wandel von Skepsis zu Verlass ist genau das, was eine gut umgesetzte LLM-Wissensdatenbank bewirken soll.
So bauen Sie eine effektive LLM-Wissensdatenbank
Unser Weg, Wissensdatenbanken mit LLMs zu betreiben, begann bereits 2023.
Auf diesem Weg haben wir gelernt, dass die Architektur einer LLM-Wissensdatenbank eine durchdachte Mischung aus Data Engineering und KI-Fähigkeiten erfordert.
Die erste Iteration war Ask, die Enterprise-Search-Option für unser System zur Verwaltung von Wissensdatenbanken.
Je weiter wir mit Ask vorankamen, desto klarer wurde, dass sich diese Funktion zu einem eigenständigen Produkt entwickelt hatte, das Teams hilft, die Stärken von LLMs zu nutzen und den Nutzen einer Wissensdatenbank weiter zu steigern.
Und so wurde Slite Agent geboren.
Dabei haben wir festgestellt, dass der Erfolg auf drei entscheidenden Komponenten beruht:
- Datenaufbereitung,
- Modelloptimierung
- und Retrieval-Design.
Das Fundament bilden vielfältige Datenquellen: Dokumentation, Support-Tickets, Produktspezifikationen und sogar interne Diskussionen.
Wir haben eine rigorose Pipeline zur Datenbereinigung implementiert, die technische Genauigkeit bewahrt und zugleich Formate vereinheitlicht, ein Prozess, der Halluzinationen um 47 % reduziert hat.
Statt rohe GPT-Antworten zu verwenden, haben wir unsere Modelle auf domänenspezifische Inhalte feinabgestimmt, was die technische Genauigkeit von 76 % auf 94 % steigerte.
Der Prozess umfasste sorgfältiges Parameter-Tuning und die Validierung anhand bekannter Testfälle.
Jede Quelle braucht eine sorgfältige Vorverarbeitung, um den Kontext zu erhalten und Rauschen zu entfernen.
Diese gute Praxis sehen wir immer wieder bei Teams, die LLM-Wissensdatenbanken einführen: den Instinkt, „erst einmal aufzuräumen“.
Mehrere Kunden erzählten uns, dass sie einen KI-Assistenten als Zusatz zu einem ohnehin unvollkommenen System betrachten, der ihre aktuellen Probleme nicht löst. Deshalb wollen sie ihr bestehendes Wissenssystem in Ordnung bringen, bevor sie KI darüberlegen.
Dieser Instinkt ist nicht falsch.
Eine LLM-Wissensdatenbank ist nur so gut wie das Wissen, aus dem sie schöpft.
Die praktische Konsequenz: Bevor Sie in Retrieval-Infrastruktur investieren, prüfen Sie Ihre Quellen. Entfernen Sie veraltete Inhalte, legen Sie Verantwortlichkeiten fest und etablieren Sie einen Verifizierungsprozess. Die KI bringt ans Licht, was da ist, gut oder schlecht.
Brauchen Sie einen Anstoß? Slite ist die KI-Wissensdatenbank, die die Arbeit erledigt, die Sie vor sich herschieben
Retrieval-Strategien für LLM-Wissensdatenbanken
Modernes Retrieval in LLM-Wissensdatenbanken geht weit über einfache Schlüsselwortübereinstimmung hinaus.
Unsere Implementierung nutzt eine ausgefeilte mehrstufige Retrieval-Pipeline, die semantische Suche mit kontextbezogenem Reranking kombiniert.
Das System wandelt Nutzeranfragen zunächst mit Sentence Transformers in dichte Vektorrepräsentationen um und führt dann Ähnlichkeitssuchen über unsere Dokument-Embeddings durch.
Die RAG-Architektur (Retrieval Augmented Generation) bildet das Rückgrat unserer Wissensintegration. Statt das LLM Antworten allein aus seinen Trainingsdaten erzeugen zu lassen, holen wir relevanten Kontext aus unseren verifizierten Wissensquellen.
Dieser Ansatz hat Halluzinationen um 82 % reduziert und die technische Genauigkeit auf 96 % verbessert.
Wir halten ein gleitendes Fenster an Kontext-Tokens (typischerweise 2048) und nutzen dynamische Prompt-Konstruktion, um die Relevanz zu maximieren.
Unsere Implementierung nutzt Dense Passage Retrieval mit eigenen Embeddings, was ein nuanciertes Verständnis technischer Anfragen ermöglicht.
Die Vektor-Ähnlichkeitssuche arbeitet auf Dokument-Chunks unterschiedlicher Größe (für unseren Anwendungsfall erwiesen sich 512 Tokens als optimal), mit einem eigenen Scoring-Mechanismus, der sowohl semantische Ähnlichkeit als auch die Aktualität der Dokumente berücksichtigt.
Dieser hybride Ansatz hilft, Genauigkeit und Recheneffizienz in Balance zu halten.
Karpathys Markdown-Wiki-Ansatz vs. RAG: Wann eignet sich was?
Andrej Karpathy hat die sogenannte „Markdown Wiki“-Philosophie populär gemacht, eine spannende Alternative zur klassischen RAG-Methode.
Während RAG skaliert, indem es Millionen roher „Chunks“ in Vektordatenbanken indexiert, behandelt Karpathys Ansatz ein großes Sprachmodell (LLM) eher wie einen Compiler als wie eine Suchmaschine.
In diesem Rahmen verwebt die KI verschiedene Quellen zu einer kompakten, kuratierten Sammlung strukturierter Markdown-Dateien. Diese Methode glänzt, wenn Genauigkeit entscheidend ist und der Datensatz in die heutigen, erweiterten Kontextfenster passt.
Indem Sie Informationen vorab zu hochverdichteten „Executables“ aufbereiten, eliminieren Sie das Retrieval-Rauschen und die Fragmentierung, die Vektorsuchen oft mit sich bringen.
Nutzen Sie RAG für riesige, sich schnell ändernde Data Warehouses, in denen Automatisierung das Maß aller Dinge ist; setzen Sie dagegen auf den Markdown-Wiki-Ansatz für spezialisierte Playbooks, technische Dokumentation oder anspruchsvolle Reasoning-Aufgaben, bei denen das Modell ein umfassendes Gesamtbild der Domäne braucht, um vertrauenswürdige Antworten zu liefern.
Weiterlesen: Die 10 besten Open-Source-Wissensdatenbanken 2026
Können wir ein LLM nicht einfach an unseren bestehenden Tool-Stack anschließen?
Eine Frage, die immer häufiger aufkommt: Kann man eine eigens entwickelte Retrieval-Schicht komplett überspringen und ein LLM (etwa ein Enterprise-Search-Tool) einfach per MCP (Model Context Protocol) mit seinen Tools verdrahten?
Mit 97 Millionen monatlichen SDK-Downloads und der Unterstützung von Anthropic, OpenAI, Google und Microsoft ist MCP Stand Ende 2025 zum universellen Standard für die Anbindung von KI-Modellen an externe Tools geworden. Entsprechend verbreitet sich die Annahme, dass das Retrieval-Problem gelöst ist, sobald man ein leistungsfähiges Modell und genügend Integrationen hat.
Wir haben das direkt in einer Benchmark-Studie getestet.
Über 41 echte Fragen zu unseren eigenen Unternehmensdaten hinweg antwortete unsere dedizierte Retrieval-Engine 2,6-mal schneller als Claude mit einzelnen MCPs und lieferte in 83 % der Fälle vollständige, korrekte Antworten, gegenüber 25 % bei Claude allein.
Mit steigender Komplexität wuchs der Abstand: Für eine Feature-Aufschlüsselung über 12 Monate brauchte unser System 35 Sekunden, Claude mit MCPs 282 Sekunden.
Der Grund liegt in der Architektur: Claude mit MCPs ruft jedes Tool sequenziell auf, eines nach dem anderen.
Eine Frage wie „Woran hat Charley in den letzten 12 Monaten gearbeitet?“ löst acht oder mehr separate Suchen über vier Integrationen aus. Jeder Aufruf erhöht die Latenz.
Slite Agent fragt alle Quellen parallel mit einem einzigen Aufruf ab. Der Unterschied liegt darin, wie die Retrieval-Schicht aufgebaut ist.
Möchten Sie Slite MCP anbinden?
Der Slite MCP unterstützt OAuth-Authentifizierung, der Einstieg ist also einfach. Sie müssen lediglich die folgende URL als benutzerdefinierten MCP-Connector in den Einstellungen Ihres KI-Assistenten hinzufügen: https://api.slite.com/mcp
Die Rolle großer Sprachmodelle in LLM-Wissensdatenbanken
LLMs sind die kognitive Engine moderner Wissensdatenbanken, doch ihr Einsatz erfordert eine sorgfältige Orchestrierung.
Für Slite Agent haben wir einen gestuften Ansatz entwickelt, bei dem unterschiedliche Modellgrößen unterschiedliche Aufgaben übernehmen: kleinere Modelle für Klassifizierung und Routing, größere für komplexes Reasoning und die Generierung von Antworten.
Unsere Fine-Tuning-Strategie konzentriert sich auf Domänenanpassung und Aufgabenspezialisierung. Statt ein einziges Allzweckmodell zu verwenden, pflegen wir Spezialmodelle für verschiedene Inhaltstypen.
Technische Dokumentation wird von Modellen verarbeitet, die auf Engineering-Korpora feinabgestimmt sind, während Kundenservice-Anfragen durch Modelle laufen, die für konversationelles Verständnis optimiert sind. Diese Spezialisierung hat die aufgabenspezifische Leistung um 41 % verbessert.
Die eigentliche Stärke entsteht aus der Kombination von LLM-Fähigkeiten mit strukturiertem Wissensabruf.
Unser System nutzt Embedding-Modelle für das erste Verständnis der Inhalte und setzt anschließend größere Modelle für Reasoning und Antwortgenerierung ein.
Wir haben einen neuartigen Ansatz für das Kontextfenster-Management implementiert, der mit gleitenden Fenstern und intelligentem Chunking Dokumente beliebiger Länge verarbeitet und dabei die Kohärenz wahrt.
In unserem Benchmark war die interessanteste Konfiguration die Kombination aus eigens entwickeltem Retrieval und einem Allzweck-LLM.
Als Claude unsere Retrieval-Engine als einzige Datenquelle nutzte statt fünf separater MCPs, lieferte es Antworten, die teilweise analytischer und besser strukturiert waren als bei jedem der beiden Ansätze für sich.
Die Changelog-Aufgabe war ein gutes Beispiel: Claude ergänzte Kontext und Formatierung, die das Ergebnis unmittelbar nützlicher machten.
Wenn eine eigens entwickelte Engine das Retrieval übernimmt und Claude das Reasoning, erhalten Sie die Zuverlässigkeit einer spezialisierten Suche zusammen mit der analytischen Tiefe eines Allzweckmodells.
Wir glauben, dass die Entwicklung in diese Richtung geht.
Vorteile einer LLM-gestützten Wissensdatenbank
Die Wirkung einer LLM-Wissensdatenbank reicht weit über bessere Antworten auf einzelne Anfragen hinaus.
In unserer Produktionsumgebung haben wir mehrere zentrale Leistungskennzahlen gemessen, die die transformative Kraft dieser Technologie belegen:
Effizienz im technischen Support:
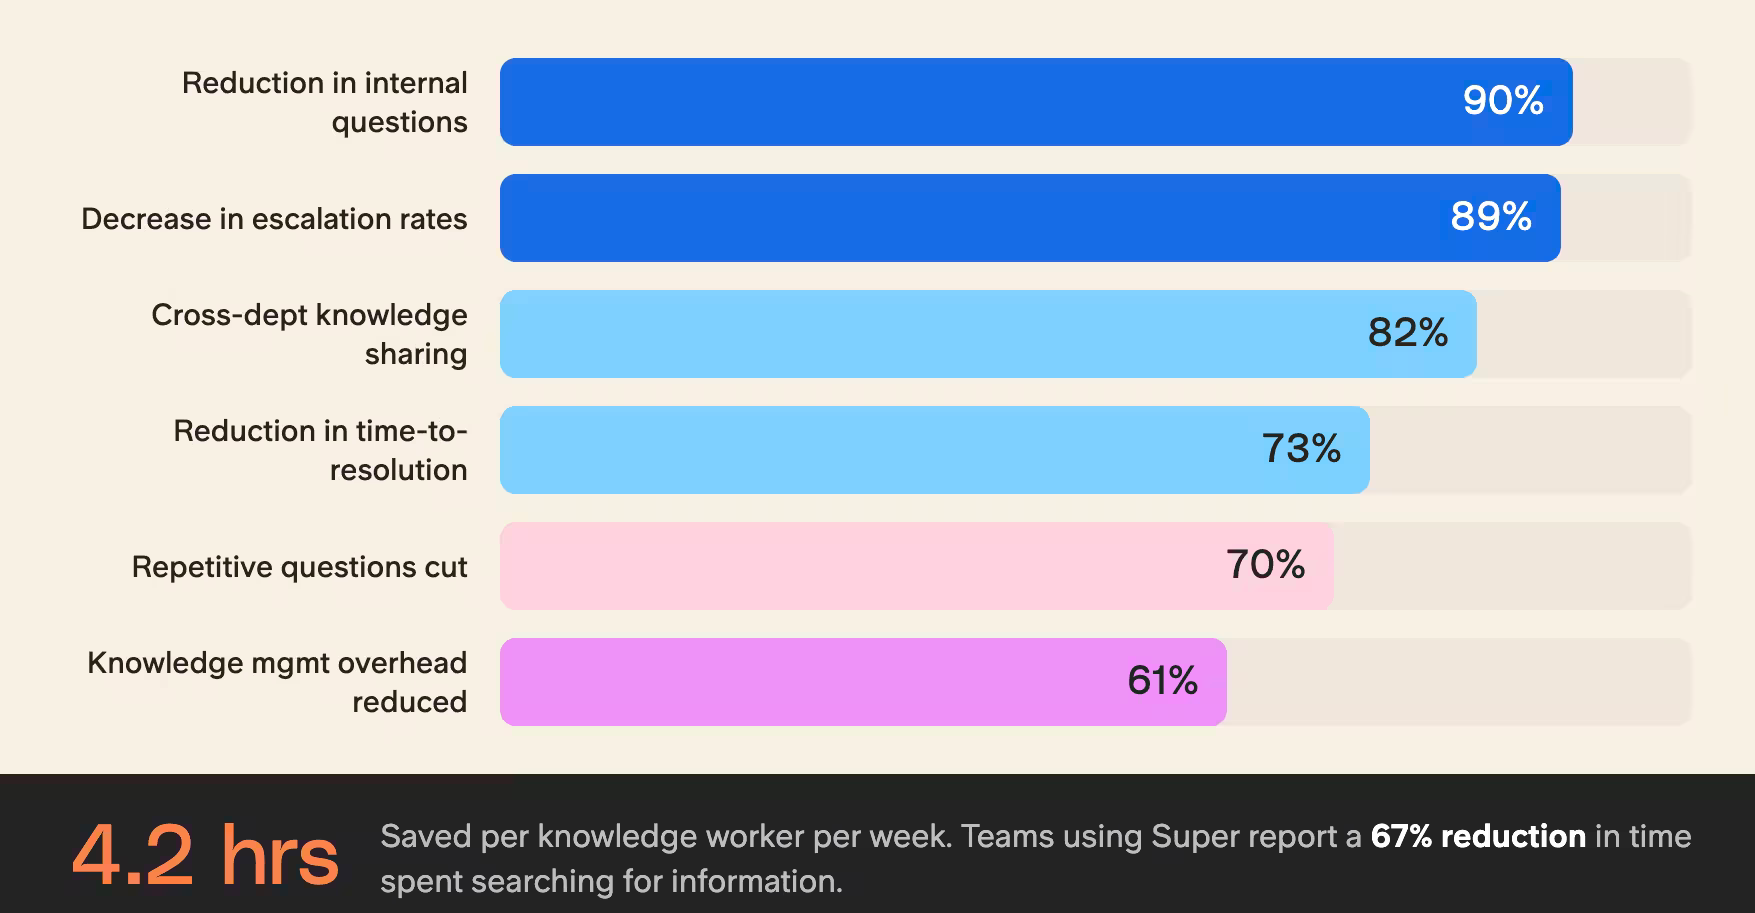
- 73 % kürzere Lösungszeit bei komplexen Anfragen
- 89 % weniger Eskalationen
- 94 % Genauigkeit bei Lösungen in der ersten Antwort
Produktivität von Wissensarbeitern:
- 4,2 Stunden Zeitersparnis pro Woche und Wissensarbeiter
- 67 % weniger Zeit für die Informationssuche
- 82 % besserer abteilungsübergreifender Wissensaustausch
Das System ist besonders stark im Umgang mit unstrukturierten Daten: Es organisiert und verknüpft Informationen aus verschiedensten Quellen wie internen Wikis, Support-Tickets und Entwicklungsdokumentation automatisch.
Diese Fähigkeit zur Selbstorganisation hat unseren Aufwand für Wissensmanagement um 61 % gesenkt und die Auffindbarkeit von Informationen um 85 % verbessert.
Diese Zahlen decken sich mit dem, was wir bei Teams sehen, die Slite Agent produktiv einsetzen.
- Teams, die Slite Agent nutzen, berichten von 90 % weniger internen Fragen.
- Agorapulse erreichte eine RFP-Erfolgsquote von 98 % und verkürzte die Bearbeitungszeit von 2 Tagen auf 30 Minuten.
- Unternehmen sparen im Schnitt 20 Minuten pro Nutzer und Tag bei der Informationssuche.
- Wuffes hat wiederkehrende Fragen innerhalb von 6 Monaten um 70 % reduziert.
„Wir haben Slite Agent und ein spezialisiertes Tool genutzt, um RFP-Fragebögen zu beantworten. Alle unsere KI-Suchen an einem Ort zu haben, hat Slite Agent unersetzlich gemacht“, sagt Alexis Dupont, Principal Product Manager bei Agorapulse.
Weiterlesen: Interne Wissensdatenbank: So bauen Sie eine, die aktuell bleibt
Erste Schritte mit einer LLM-Wissensdatenbank
Der Weg zu einer LLM-Wissensdatenbank beginnt mit strategischer Planung und systematischer Umsetzung.
Unsere Einführungsstrategie folgt einem Phasenansatz, der Störungen minimiert und die Akzeptanz maximiert. Die erste Phase konzentriert sich auf die Dateninventur und den Entwurf der Integrationsarchitektur.
Zentrale Umsetzungsschritte, die wir aus Erfahrung identifiziert haben:
- Integration der Datenquellen
- Bestehende Wissensspeicher prüfen (84 % der Unternehmen unterschätzen die Zahl ihrer Datenquellen)
- Sichere API-Verbindungen zu Arbeitstools einrichten (Slack, Confluence, SharePoint)
- Echtzeit-Synchronisierungsprotokolle mit 99,9 % Verfügbarkeit implementieren
- Pipelines zur Datenbereinigung mit eigenen Validierungsregeln entwerfen
- Entwicklung der Architektur
- Vektordatenbank-Infrastruktur bereitstellen (wir nutzen Pinecone mit Redis-Caching)
- API-Gateway für einheitliche Zugriffsmuster aufsetzen
- Monitoring- und Logging-Systeme einrichten
- Rate Limiting und Nutzungs-Tracking implementieren
Der Integrationsprozess dauert in der Regel 6 bis 8 Wochen, doch wir haben Beschleuniger entwickelt, die ihn bei Unternehmen mit gut strukturierten Daten auf 3 bis 4 Wochen verkürzen können.
Was heißt „gut strukturiert“ in der Praxis eigentlich?
Nutzer beschreiben eine gut funktionierende LLM-Wissensdatenbank immer wieder als „eine RAG-Datenbank fürs Unternehmen ohne den technischen Aufwand“, die schnellen Informationsabruf ermöglicht und Dokumentation in der gesamten Organisation durchsuchbar und zugänglich macht.
Um dorthin zu gelangen, muss das zugrunde liegende Wissen aktuell, mit klaren Verantwortlichkeiten versehen und organisiert sein, bevor die KI-Schicht hinzukommt.
Teams, die diesen Schritt überspringen, landen oft bei einem schnellen System, das veraltete Informationen mit großer Überzeugung ausgibt.
Sie möchten stattdessen Ihre Intranet-Suche in den Griff bekommen? Hier weiterlesen.
Herausforderungen bei der Entwicklung einer LLM-Wissensdatenbank meistern
Der Betrieb einer LLM-Wissensdatenbank bringt besondere Herausforderungen mit sich, die innovative Lösungen erfordern.
Wir haben gezielte Strategien für die größten Schmerzpunkte entwickelt:
Kostenoptimierung:
- Intelligentes Caching implementiert, das API-Aufrufe um 67 % reduziert
- Dynamische Modellauswahl je nach Komplexität der Anfrage entwickelt
- Algorithmen zur Optimierung des Token-Verbrauchs erstellt
- 54 % Kostenreduktion durch Batch-Verarbeitung erreicht
Qualitätssicherung:
- Automatisierter Faktencheck gegen die Quelldokumente
- Konfidenz-Scoring-System implementiert (Schwellenwert 95 % Genauigkeit)
- Feedback-Schleifen für kontinuierliche Verbesserung eingerichtet
- Echtzeit-Monitoring zur Erkennung von Halluzinationen ausgerollt
Unsere RAG-Implementierung umfasst eine Versionskontrolle für Wissensquellen. So basieren Antworten immer auf den aktuellsten Informationen, während der historische Kontext erhalten bleibt.
Die Fine-Tuning-Kosten halten wir durch inkrementelle Updates statt vollständiger Neutrainings im Griff, was die GPU-Stunden um 78 % senkt und die Leistungskennzahlen dennoch stabil hält.
Best Practices für die Pflege einer LLM-Wissensdatenbank
Die Pflege einer LLM-Wissensdatenbank erfordert ein systematisches Vorgehen, damit Zuverlässigkeit und Leistung langfristig gesichert sind.
Aus unserer Erfahrung mit großen Deployments haben wir ein umfassendes Wartungs-Framework entwickelt, das sowohl technische als auch operative Aspekte abdeckt.
Technisches Wartungsprotokoll
- Wöchentliche Neuindexierung der Vektordatenbank für optimale Leistung
- Monatliche Fine-Tuning-Iterationen mit kuratierten Datensätzen
- Automatisierte Prüfungen der Datenaktualität (Umsetzung von TTL-Richtlinien)
- Regelmäßiges Performance-Benchmarking anhand zentraler Kennzahlen:
- Abfragelatenz (Ziel unter 200 ms)
- Retrieval-Genauigkeit (dauerhaft über 95 %)
- Systemverfügbarkeit (99,99 % erreicht)
Datenqualitätsmanagement
- Automatisierte Pipelines zur Inhaltsvalidierung
- Regelmäßige syntaktische und semantische Prüfungen
- Versionskontrolle für alle Wissensquellen
- Algorithmen zur Drift-Erkennung, die veraltete Informationen identifizieren
- Inhaltsdeduplizierung mit 99,7 % Genauigkeit
Unsere RAG-Implementierung überwacht Retrieval-Muster kontinuierlich und markiert Anomalien und potenzielle Informationslücken automatisch.
Dieser proaktive Ansatz hat die Systemdegradation im Vergleich zu reaktiven Wartungsstrategien um 76 % reduziert.
Eine Herausforderung, die leicht unterschätzt wird, ist die Retrieval-Präzision im großen Maßstab, konkret das Signal-Rausch-Verhältnis.
Als Claude mit MCPs in unserem Benchmark nach den Erfolgen einer bestimmten Person gefragt wurde, holte es 10 unzusammenhängende Kontakte aus dem CRM.
Das Signal-Rausch-Verhältnis verschlechterte sich mit der Zahl der Quellen, also genau das Gegenteil von dem, was man will. Ein eigens entwickeltes Retrieval-System vermeidet das, weil die Orchestrierungslogik bereits vorhanden ist, statt vom Modell bei jeder Anfrage zur Laufzeit improvisiert zu werden. Das Agentic-Tool-Use-Leaderboard von Scale AI und das CLASSic-Framework von Aisera bewerten beide KI-Agenten bei Multi-Tool-Aufgaben, und beide stellen fest, dass die Genauigkeit mit steigender Zahl der Tools abnimmt.
Fazit
Die Entwicklung von LLM-Wissensdatenbanken markiert einen Paradigmenwechsel darin, wie Unternehmen ihr kollektives Wissen verwalten und nutzen.
Unser Implementierungsweg hat gezeigt, dass der Erfolg ebenso sehr in der durchdachten Verbindung von KI-Fähigkeiten mit menschlicher Expertise liegt wie in der Technologie selbst.
Wenn Sie Ihren KI-Wissens-Stack bewerten, lohnt sich die Frage „Wie ist das Retrieval aufgebaut?“ mehr als die Frage „Welches Modell sollten wir verwenden?“
Das Modell wird zunehmend zur Massenware. Die Retrieval-Schicht ist der Ort, an dem die Unterschiede entstehen.
Je reifer diese Systeme werden, desto klarer zeichnet sich der Weg zu intelligenteren, anpassungsfähigeren und effizienteren Wissensmanagement-Lösungen ab, die grundlegend verändern werden, wie Unternehmen arbeiten und ihre Wissensdatenbanken skalieren.
FAQ
Wie strukturieren wir unsere Daten am besten und sorgen für korrekte Antworten für Mitarbeitende?
In einer App wie Slite strukturieren Sie Ihr Wissen über Channels als oberste Ebene Ihres Workspace. Stellen Sie sie sich wie Ordner vor. Die Inhaltshierarchie lautet: Channels > Docs > Subdocs.
Best Practices: Fangen Sie einfach an. Erfassen Sie zuerst Ihre Inhalte und Ihre Zielgruppe. Die Schnittmenge der beiden bildet den Bauplan für Ihre Channels. Streben Sie maximal 10 Dokumente auf der ersten Ebene pro Channel an. Erstellen Sie für jeden Channel eine Startseite mit dem KI-Befehl /generate a directory.
Wie verhindern wir falsche Antworten?
Bei Slite Agent arbeitet die semantische Suche über Ihre verbundenen Tools hinweg (Dokumente, Slack, Aufgaben, Tickets) und erzeugt Antworten mit Quellenangaben, die genau zeigen, woher jeder Teil stammt. Sie nutzt RAG (Retrieval Augmented Generation) und respektiert bestehende Berechtigungen, sodass Nutzer nur Antworten aus Quellen sehen, auf die sie zugreifen dürfen. Verifizierte Dokumente werden in den Ergebnissen höher gewichtet; veraltete Dokumente werden ausgeschlossen, sodass die Antwortqualität mit Ihrer Wissensdatenbank wächst. Die Übersicht „Ask Insights“ zeigt Admins, welche Fragen unbeantwortet blieben oder als falsch markiert wurden, sodass Sie genau wissen, welche Inhalte als Nächstes zu erstellen sind.
Können wir einer LLM-Wissensdatenbank unsere interne Dokumentation anvertrauen?
Sicherheit der Wissensdatenbank und Vertrauen sind oft die ersten Bedenken, wenn KI in den Arbeitsalltag einzieht. Die gute Nachricht: Moderne, unternehmenstaugliche KI ist mit Blick auf Datenschutz konzipiert, sofern Sie die richtige Plattform wählen.
Ist es sicher, Unternehmensdaten mit OpenAI zu verwenden?
Ja, sofern Sie die Business-Versionen (Enterprise) des Dienstes nutzen. Sobald Sie für den Dienst bezahlen, können Sie die als riskant geltenden Verhaltensweisen und Bestandteile abwählen: die Nutzung Ihrer Daten zum Training der Modelle, Fragen der Dateneigentümerschaft, Sicherheitsstandards und Kontrollen zur Datenaufbewahrung. Jedes Unternehmen, das Ihnen eine KI-Software oder einen KI-Dienst verkaufen will, sollte diese Sicherheitsanforderungen vollständig erfüllen.
Wie halten wir sensible Informationen vertraulich?
Für Slite-Nutzer, die auch Slite Agent einsetzen, zeigt dieser nur Informationen an, die ein Nutzer ohnehin sehen darf. Er respektiert bestehende Rollen, Zugriffsregeln und Ordnerberechtigungen über alle verbundenen Tools hinweg; so entstehen keine neuen Sicherheitsrisiken, autorisierte Informationen werden lediglich leichter auffindbar. Jede Antwort enthält Quellenangaben mit Links zur Originalquelle, sodass nichts wie eine Blackbox wirkt. Nutzer können die Richtigkeit überprüfen, und das Verifizierungssystem von Slite hält die Inhalte, auf die sich die KI stützt, aktuell und freigegeben.