Une base de connaissances LLM (une base de connaissances IA pilotée par un LLM) utilise un grand modèle de langage pour lire et interpréter les informations sélectionnées qu'elle stocke, en combinant la compréhension du langage du modèle et l'exactitude factuelle du référentiel.
Nous avons mis en œuvre de grands modèles de langage lors du développement de notre base de connaissances, Slite, puis de notre outil de recherche IA, et cet article vous raconte comment nous les avons implémentés.
Une base de connaissances entretenue par un LLM est un élément d'une idée plus vaste, le cerveau d'entreprise, une couche de contexte persistante au service des personnes comme des agents.
Points clés à retenir :
- Là où les systèmes classiques reposent sur la correspondance exacte de mots-clés et une catégorisation prédéfinie, les LLM comprennent les relations sémantiques et le contexte d'une manière qui transforme le stockage et la récupération de l'information dans les bases de connaissances.
- L'innovation majeure tient à la capacité des LLM à créer des connexions neuronales dynamiques entre les éléments d'information, ce qui en fait un outil puissant que des innovateurs tech comme Andrej Karpathy exploitent à leur avantage.
- Un nettoyage rigoureux des données améliore l'exactitude tout en standardisant les formats, un processus qui a réduit les hallucinations de 47 %.
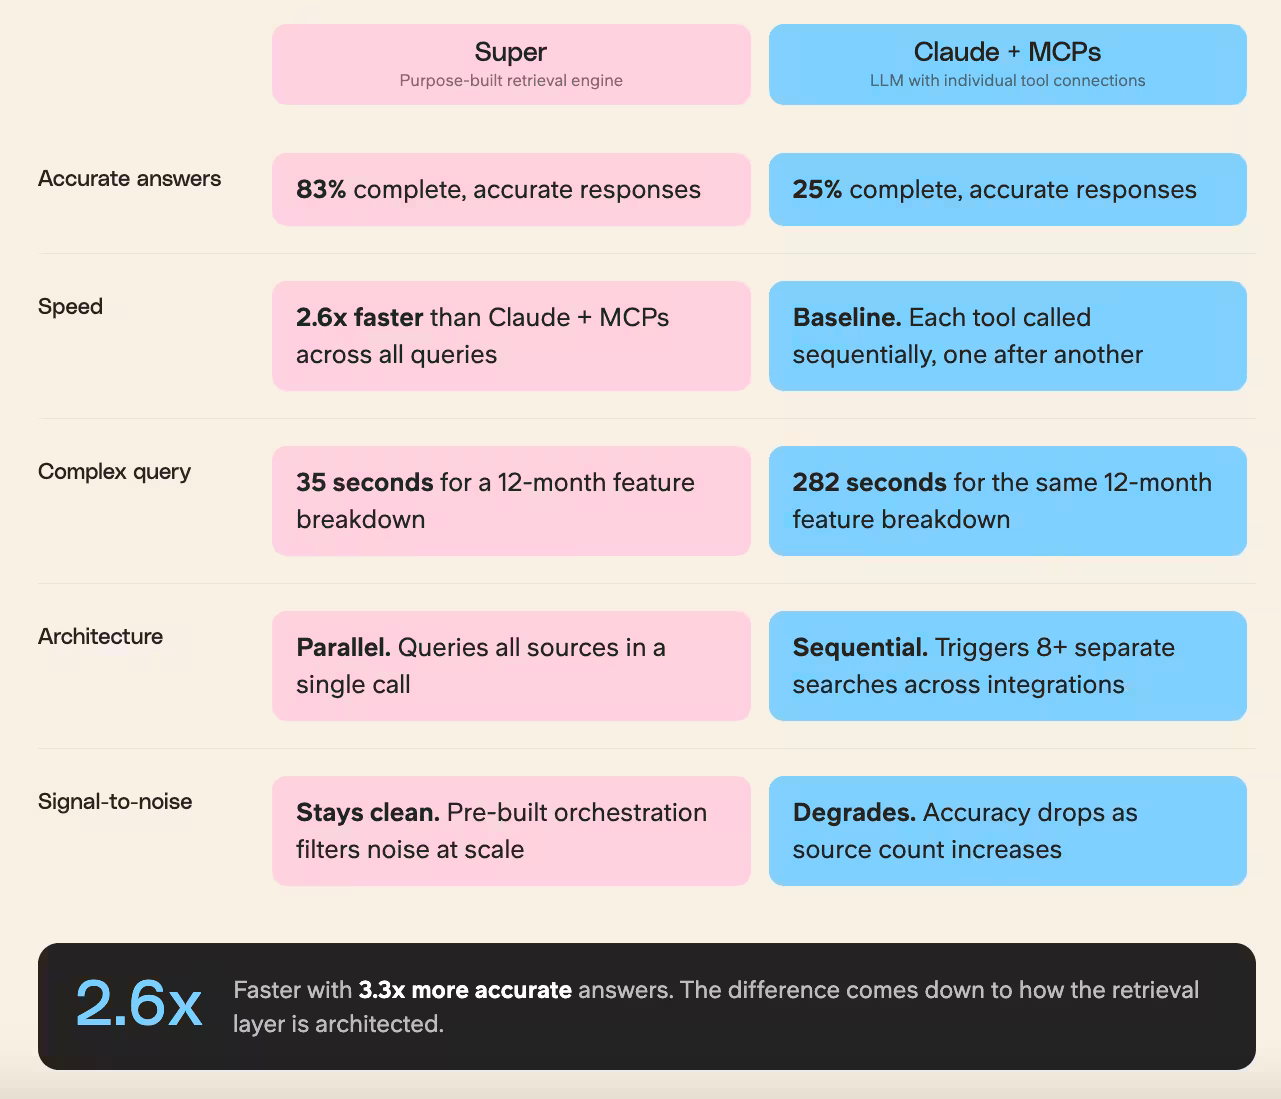
- Se passer entièrement d'une couche de récupération dédiée et se contenter de brancher un LLM à vos outils via MCP peut priver votre équipe d'exactitude et de rapidité : notre moteur de récupération dédié a répondu 2,6 fois plus vite que Claude avec des MCP individuels, et a fourni des réponses complètes et exactes dans 83 % des cas contre 25 % avec Claude seul.
Comment fonctionnent les bases de connaissances LLM
Une base de connaissances LLM se distingue fondamentalement des systèmes de documentation traditionnels en utilisant de grands modèles de langage comme moteur de traitement central. L'effet sur l'usage est mesurable : les utilisateurs ayant accès à l'IA créent 55 % de documents de plus par mois que ceux qui n'y ont pas accès.
Fondamentalement, c'est un système capable de traiter à la fois des données structurées et non structurées, de la documentation formelle aux conversations informelles de l'équipe.
Par exemple, lorsque nous avons déployé notre première base de connaissances LLM, elle a automatiquement relié les spécifications techniques aux retours utilisateurs et aux tickets de support, créant un contexte riche que nous n'avions pas explicitement programmé.
Ces systèmes s'appuient sur des architectures transformer et des mécanismes d'attention pour traiter le texte, ce qui leur permet de gérer des requêtes en langage naturel avec une précision inédite.
Le socle technique comprend des embeddings vectoriels sophistiqués pour la recherche sémantique, ce qui permet de trouver l'information pertinente même quand les mots-clés exacts ne correspondent pas.
La magie opère en trois grandes étapes : l'ingestion, le traitement et la récupération.
- Pendant l'ingestion, le système convertit différents formats de contenu en représentations vectorielles, en conservant le sens sémantique plutôt que de simplement stocker du texte brut. Cette transformation permet une compréhension fine des relations entre les contenus.
- L'étape de traitement repose sur un apprentissage continu à partir des nouvelles entrées, tout en maintenant le contexte sur l'ensemble de la base de connaissances. Par exemple, lorsque notre système rencontre une nouvelle documentation technique, il met automatiquement à jour les articles de support et les guides utilisateur associés, garantissant la cohérence sur tous les points de contact.
- Le mécanisme de récupération utilise un prompt engineering avancé et une gestion de la fenêtre de contexte pour extraire l'information pertinente. Contrairement à la recherche traditionnelle, qui peut renvoyer des centaines de résultats partiellement correspondants, les bases de connaissances LLM synthétisent l'information de plusieurs sources pour fournir des réponses précises et contextualisées.
La confiance dans ces systèmes se construit avec le temps.
Ashley Hortulanus, Customer Success Manager chez Uscreen, qui utilise Slite au quotidien, a bien décrit cette trajectoire :
Au début, quand nous avons commencé à l'utiliser, c'était presque difficile de faire confiance à ce qui était dit... Mais avec le temps, évidemment, il s'entraîne et il s'améliore de plus en plus. Et je dirais qu'aujourd'hui je ne remets presque plus en question ce qui est dit. C'est vraiment agréable d'avoir ça. Alors qu'avant, on se disait : bon, à qui est-ce que je pose cette question ?
Ce passage du scepticisme à la confiance est précisément ce qu'une base de connaissances LLM bien implémentée est conçue pour produire.
Construire une base de connaissances LLM efficace
Notre parcours vers l'utilisation de LLM pour alimenter une base de connaissances a commencé en 2023.
Au fil de ce parcours, nous avons appris que l'architecture d'une base de connaissances LLM exige un mélange réfléchi d'ingénierie des données et de capacités d'IA.
La première itération a été Ask, l'option de recherche d'entreprise de notre système de gestion de base de connaissances.
À mesure que nous avancions sur Ask, nous avons réalisé que cette fonctionnalité avait pris la forme d'un produit à part entière, destiné à aider les équipes à exploiter la puissance des LLM pour renforcer encore les bénéfices d'une base de connaissances.
Et c'est ainsi qu'est né Slite Agent.
Au cours de ce processus, nous avons constaté que le succès repose sur trois composantes essentielles :
- la préparation des données,
- l'optimisation du modèle,
- et la conception de la récupération.
Le socle commence par des sources de données variées : documentation, tickets de support, spécifications produit et même discussions internes.
Nous avons mis en place un pipeline rigoureux de nettoyage des données qui préserve l'exactitude technique tout en standardisant les formats, un processus qui a réduit les hallucinations de 47 %.
Plutôt que d'utiliser des réponses GPT brutes, nous avons entraîné nos modèles par fine-tuning sur du contenu spécifique à notre domaine, ce qui a fait passer l'exactitude technique de 76 % à 94 %.
Le processus a impliqué un réglage minutieux des paramètres et une validation sur des cas de test connus.
Chaque source nécessite un prétraitement soigneux pour conserver le contexte tout en éliminant le bruit.
Cette bonne pratique, nous l'avons observée à maintes reprises chez les équipes qui adoptent des bases de connaissances LLM : le réflexe de « faire le ménage d'abord ».
Plusieurs clients nous ont dit qu'ils voient un assistant IA comme un complément à un système déjà imparfait plutôt que comme une partie de la solution à leurs problèmes actuels ; ils veulent donc corriger leur configuration de connaissances existante avant d'y superposer l'IA.
Ce réflexe n'est pas mauvais.
Une base de connaissances LLM ne vaut que ce que valent les connaissances sous-jacentes dont elle se nourrit.
Conséquence pratique : avant d'investir dans une infrastructure de récupération, auditez vos sources. Supprimez le contenu obsolète, attribuez des responsables et mettez en place un processus de vérification. L'IA fera remonter tout ce qui s'y trouve, le bon comme le mauvais.
Besoin d'un coup de pouce ? Slite est la base de connaissances IA qui fait le travail que vous remettez à plus tard
Stratégies de récupération pour les bases de connaissances LLM
La récupération moderne dans les bases de connaissances LLM va bien au-delà de la simple correspondance de mots-clés.
Notre implémentation utilise un pipeline de récupération sophistiqué à plusieurs étapes, qui combine recherche sémantique et reranking contextuel.
Le système convertit d'abord les requêtes des utilisateurs en représentations vectorielles denses à l'aide de sentence transformers, puis effectue des recherches de similarité sur les embeddings de nos documents.
L'architecture RAG (Retrieval Augmented Generation) constitue la colonne vertébrale de notre intégration des connaissances. Plutôt que de laisser le LLM générer des réponses uniquement à partir de ses données d'entraînement, nous allons chercher le contexte pertinent dans nos sources de connaissances vérifiées.
Cette approche a réduit les hallucinations de 82 % et porté l'exactitude technique à 96 %.
Nous maintenons une fenêtre glissante de tokens de contexte (généralement 2048) et construisons les prompts de façon dynamique pour maximiser la pertinence.
Notre implémentation utilise le dense passage retrieval avec des embeddings personnalisés, ce qui permet une compréhension fine des requêtes techniques.
La recherche de similarité vectorielle opère sur des chunks de documents de tailles variables (512 tokens se sont révélés optimaux pour notre cas d'usage), avec un mécanisme de scoring personnalisé qui prend en compte à la fois la similarité sémantique et la fraîcheur des documents.
Cette approche hybride aide à concilier exactitude et efficacité de calcul.
L'approche Markdown Wiki de Karpathy vs RAG : laquelle utiliser et quand ?
Andrej Karpathy a popularisé la philosophie dite du « Markdown Wiki », une alternative intrigante à la méthode RAG traditionnelle.
Là où le RAG passe à l'échelle en indexant des millions de « chunks » bruts dans des bases de données vectorielles, l'approche de Karpathy traite un grand modèle de langage (LLM) davantage comme un compilateur que comme un moteur de recherche.
Dans ce cadre, l'IA tisse diverses sources en une collection compacte et soignée de fichiers Markdown structurés. Cette méthode brille lorsque l'exactitude est cruciale et que le jeu de données tient dans les fenêtres de contexte étendues des modèles actuels.
En prétraitant l'information sous forme d'« exécutables » à haute densité, vous éliminez le bruit de récupération et la fragmentation qui accompagnent souvent les recherches vectorielles.
Utilisez le RAG pour de vastes entrepôts de données en évolution rapide où l'automatisation règne en maître ; optez en revanche pour l'approche Markdown Wiki pour des playbooks spécialisés, de la documentation technique ou des tâches de raisonnement à fort enjeu, où le modèle a besoin d'une vision d'ensemble complète du domaine pour fournir des réponses fiables.
Pour aller plus loin : Les 10 meilleures bases de connaissances open source en 2026
Ne peut-on pas simplement connecter un LLM à notre stack d'outils existante ?
Une question qui revient de plus en plus souvent : peut-on se passer entièrement d'une couche de récupération dédiée et simplement brancher un LLM (comme un outil de recherche d'entreprise) à ses outils via MCP (Model Context Protocol) ?
Avec 97 millions de téléchargements mensuels du SDK et le soutien d'Anthropic, OpenAI, Google et Microsoft fin 2025, MCP est devenu le standard universel pour connecter les modèles d'IA à des outils externes, et l'idée se répand qu'avec un modèle performant et suffisamment d'intégrations, le problème de la récupération est résolu.
Nous avons testé cette hypothèse directement avec une étude comparative.
Sur 41 questions réelles portant sur les données de notre propre entreprise, notre moteur de récupération dédié a répondu 2,6 fois plus vite que Claude avec des MCP individuels, et a fourni des réponses complètes et exactes dans 83 % des cas contre 25 % avec Claude seul.
L'écart s'est creusé avec la complexité : un récapitulatif des fonctionnalités sur 12 mois a pris 35 secondes à notre système, contre 282 secondes pour Claude avec MCP.
La raison est architecturale : Claude avec MCP appelle chaque outil de manière séquentielle, l'un après l'autre.
Une question comme « Sur quoi Charley a-t-il travaillé ces 12 derniers mois ? » déclenche huit recherches distinctes ou plus dans quatre intégrations. Chaque appel ajoute de la latence.
Slite Agent interroge toutes les sources en parallèle avec un seul appel. La différence tient à la façon dont la couche de récupération est architecturée.
Envie de connecter Slite MCP ?
Le Slite MCP prend en charge l'authentification OAuth, donc la mise en route est simple. Il vous suffit d'ajouter l'URL suivante comme connecteur MCP personnalisé dans les paramètres de votre assistant IA : https://api.slite.com/mcp
Le rôle des grands modèles de langage dans les bases de connaissances LLM
Les LLM constituent le moteur cognitif des bases de connaissances modernes, mais leur implémentation exige une orchestration soignée.
Pour Slite Agent, nous avons développé une approche par paliers où des modèles de tailles différentes gèrent des tâches différentes : les petits modèles pour la classification et le routage, les plus grands pour le raisonnement complexe et la génération de réponses.
Notre stratégie de fine-tuning se concentre sur l'adaptation au domaine et la spécialisation par tâche. Plutôt que d'utiliser un seul modèle généraliste, nous maintenons des modèles spécialisés pour différents types de contenu.
La documentation technique est traitée par des modèles affinés sur des corpus d'ingénierie, tandis que les requêtes du service client passent par des modèles optimisés pour la compréhension conversationnelle. Cette spécialisation a amélioré les performances par tâche de 41 %.
La vraie puissance vient de la combinaison des capacités des LLM avec une récupération structurée des connaissances.
Notre système utilise des modèles d'embeddings pour la compréhension initiale du contenu, puis fait appel à des modèles plus grands pour le raisonnement et la génération de réponses.
Nous avons mis en œuvre une approche inédite de la gestion de la fenêtre de contexte, avec des fenêtres glissantes et un chunking intelligent, pour traiter des documents de toute longueur tout en préservant la cohérence.
Dans notre benchmark, la configuration la plus intéressante a été la combinaison d'une récupération dédiée et d'un LLM généraliste.
Lorsque Claude a utilisé notre moteur de récupération comme source de données unique à la place de cinq MCP distincts, il a produit des réponses parfois plus analytiques et mieux structurées que chacune des deux approches prise isolément.
La tâche du journal des modifications en est un bon exemple : Claude a ajouté du contexte et une mise en forme qui ont rendu le résultat plus immédiatement utile.
Si un moteur dédié gère la récupération et que Claude gère le raisonnement, vous obtenez la fiabilité d'une recherche spécialisée avec la profondeur d'analyse d'un modèle généraliste.
Nous pensons que c'est dans cette direction que les choses évoluent.
Les avantages d'une base de connaissances pilotée par un LLM
L'impact de la mise en place d'une base de connaissances LLM va bien au-delà de simples améliorations du couple question-réponse.
Dans notre environnement de production, nous avons mesuré plusieurs indicateurs clés de performance qui démontrent le pouvoir de transformation de cette technologie :
Efficacité du support technique :
- 73 % de réduction du temps de résolution pour les requêtes complexes
- 89 % de baisse des taux d'escalade
- 94 % d'exactitude des solutions dès la première réponse
Productivité des travailleurs du savoir :
- 4,2 heures économisées par semaine et par travailleur du savoir
- 67 % de réduction du temps passé à chercher de l'information
- 82 % d'amélioration du partage des connaissances entre services
Le système excelle dans le traitement des données non structurées, en organisant et en reliant automatiquement l'information issue de sources variées comme les wikis internes, les tickets de support et la documentation de développement.
Cette capacité d'auto-organisation a réduit de 61 % notre charge de gestion des connaissances, tout en améliorant de 85 % la facilité à retrouver l'information.
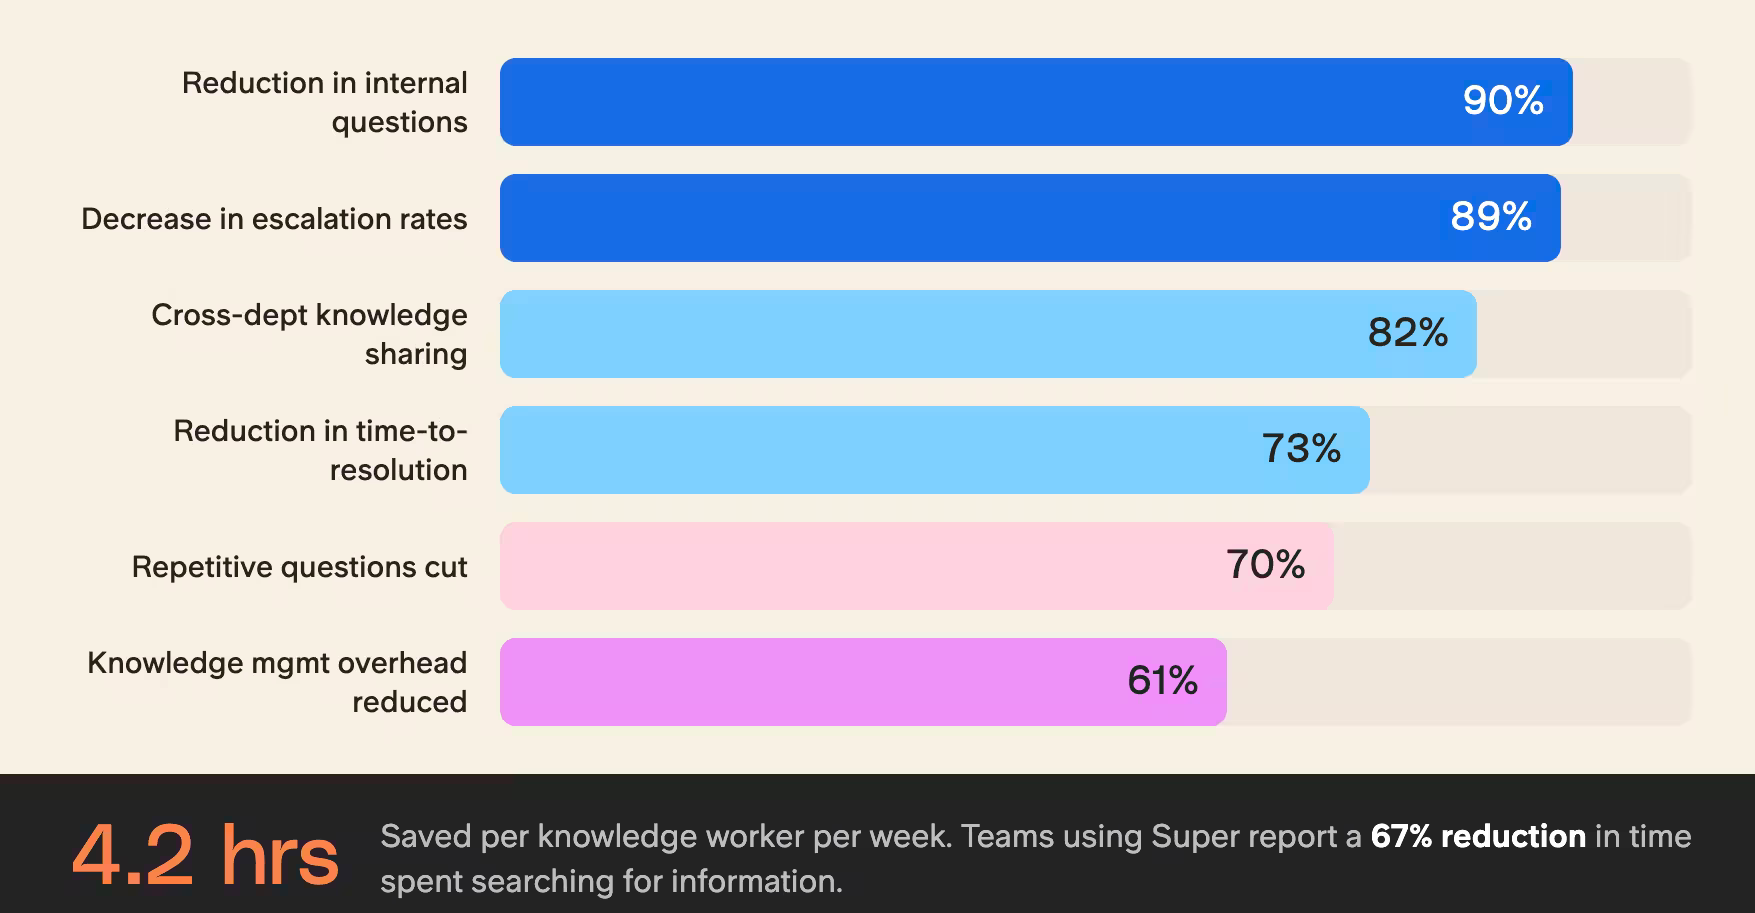
Ces chiffres sont cohérents avec ce que nous observons chez les équipes qui utilisent Slite Agent en production.
- Les équipes qui utilisent Slite Agent rapportent une réduction de 90 % des questions internes.
- Agorapulse a atteint un taux de réussite de 98 % sur ses appels d'offres (RFP) et a fait passer le temps de rédaction de 2 jours à 30 minutes.
- Les organisations économisent en moyenne 20 minutes par utilisateur et par jour dans la recherche d'information.
- Wuffes a réduit les questions répétitives de 70 % en 6 mois.
« Nous utilisions Slite Agent et un outil spécialisé pour répondre aux questionnaires d'appels d'offres. Avoir toutes nos recherches IA au même endroit a rendu Slite Agent irremplaçable », explique Alexis Dupont, Principal Product Manager chez Agorapulse.
Pour aller plus loin : Base de connaissances interne : comment en construire une qui reste à jour
Démarrer avec une base de connaissances LLM
La mise en place d'une base de connaissances LLM commence par une planification stratégique et une exécution méthodique.
Notre stratégie de déploiement suit une approche par phases qui minimise les perturbations tout en maximisant l'adoption. La phase initiale se concentre sur l'inventaire des données et la conception de l'architecture d'intégration.
Les étapes clés de mise en œuvre que l'expérience nous a permis d'identifier :
- Intégration des sources de données
- Auditer les référentiels de connaissances existants (84 % des organisations sous-estiment leurs sources de données)
- Mettre en place des connexions API sécurisées vers les outils de travail (Slack, Confluence, SharePoint)
- Implémenter des protocoles de synchronisation en temps réel avec 99,9 % de disponibilité
- Concevoir des pipelines de nettoyage des données avec des règles de validation personnalisées
- Développement de l'architecture
- Déployer l'infrastructure de base de données vectorielle (nous utilisons Pinecone avec un cache Redis)
- Établir une passerelle API pour des schémas d'accès cohérents
- Mettre en place des systèmes de monitoring et de journalisation
- Implémenter la limitation de débit et le suivi de l'utilisation
Le processus d'intégration prend généralement 6 à 8 semaines, mais nous avons développé des accélérateurs qui peuvent le ramener à 3 à 4 semaines pour les organisations dont les données sont bien structurées.
Que signifie « bien structurées » concrètement ?
Les utilisateurs décrivent régulièrement une base de connaissances LLM qui fonctionne bien comme « une base RAG d'entreprise sans la charge technique », qui permet de retrouver rapidement l'information et rend la documentation consultable et accessible dans toute l'organisation.
Y parvenir exige que les connaissances sous-jacentes soient à jour, attribuées à des responsables et organisées avant d'ajouter la couche d'IA.
Les équipes qui sautent cette étape se retrouvent souvent avec un système rapide qui fait remonter avec assurance des informations obsolètes.
Vous cherchez plutôt à comprendre la recherche sur votre intranet ? Lisez ceci.
Surmonter les défis du développement d'une base de connaissances LLM
Gérer une base de connaissances LLM soulève des défis particuliers qui appellent des solutions innovantes.
Nous avons développé des stratégies spécifiques pour répondre aux principaux points de friction :
Optimisation des coûts :
- Mise en place d'un cache intelligent réduisant les appels API de 67 %
- Développement d'une sélection dynamique du modèle selon la complexité de la requête
- Création d'algorithmes d'optimisation de la consommation de tokens
- Réduction des coûts de 54 % grâce au traitement par lots
Assurance qualité :
- Vérification automatisée des faits par rapport aux documents sources
- Mise en place d'un système de score de confiance (seuil d'exactitude de 95 %)
- Création de boucles de rétroaction pour l'amélioration continue
- Déploiement d'un monitoring en temps réel pour détecter les hallucinations
Notre implémentation RAG inclut un contrôle de version des sources de connaissances, ce qui garantit que les réponses reposent toujours sur l'information la plus récente tout en conservant le contexte historique.
Les coûts de fine-tuning sont maîtrisés grâce à des mises à jour incrémentales plutôt qu'un réentraînement complet du modèle, ce qui réduit les heures GPU de 78 % tout en maintenant les indicateurs de performance.
Bonnes pratiques pour la maintenance d'une base de connaissances LLM
Maintenir une base de connaissances LLM exige une approche systématique pour garantir fiabilité et performance sur le long terme.
Grâce à notre expérience de la gestion de déploiements à grande échelle, nous avons développé un cadre de maintenance complet qui couvre à la fois les aspects techniques et opérationnels.
Protocole de maintenance technique
- Réindexation hebdomadaire de la base de données vectorielle pour des performances optimales
- Itérations mensuelles de fine-tuning avec des jeux de données sélectionnés
- Contrôles automatisés de la fraîcheur des données (mise en place de politiques TTL)
- Benchmark régulier des performances par rapport aux indicateurs clés :
- Latence des requêtes (objectif <200 ms)
- Exactitude de la récupération (maintenue >95 %)
- Disponibilité du système (99,99 % atteints)
Gestion de la qualité des données
- Pipelines automatisés de validation du contenu
- Contrôles syntaxiques et sémantiques réguliers
- Contrôle de version pour toutes les sources de connaissances
- Algorithmes de détection de dérive pour identifier les informations obsolètes
- Déduplication du contenu avec 99,7 % d'exactitude
Notre implémentation RAG inclut un monitoring continu des schémas de récupération, qui signale automatiquement les anomalies et les lacunes potentielles d'information.
Cette approche proactive a réduit la dégradation du système de 76 % par rapport aux stratégies de maintenance réactives.
Un défi facile à sous-estimer est la précision de la récupération à grande échelle, plus précisément le rapport signal/bruit.
Dans notre benchmark, lorsqu'on a interrogé Claude avec MCP sur les réalisations d'une personne précise, il a récupéré 10 contacts sans rapport dans le CRM.
Le rapport signal/bruit s'est dégradé à mesure que le nombre de sources augmentait, soit l'inverse de ce que l'on souhaite. Un système de récupération dédié évite cet écueil parce que la logique d'orchestration existe déjà, au lieu d'être improvisée par le modèle au moment de l'inférence à chaque requête. Le classement Agentic Tool Use de Scale AI et le cadre CLASSic d'Aisera évaluent tous deux les agents IA sur des tâches multi-outils, et tous deux constatent que l'exactitude se dégrade à mesure que le nombre d'outils augmente.
Conclusion
L'évolution des bases de connaissances LLM représente un changement de paradigme dans la façon dont les organisations gèrent et utilisent leur savoir collectif.
Notre parcours d'implémentation a révélé que le succès tient à l'intégration réfléchie des capacités de l'IA avec l'expertise humaine, autant qu'à la technologie elle-même.
Au moment d'évaluer votre stack de connaissances IA, la question qui mérite d'être posée est « comment la récupération est-elle architecturée ? » plutôt que « quel modèle utiliser ? »
Le modèle devient de plus en plus une commodité. C'est dans la couche de récupération que se joue la différence.
À mesure que ces systèmes gagnent en maturité, nous observons une trajectoire claire vers des solutions de gestion des connaissances plus intelligentes, adaptatives et efficaces, qui transformeront en profondeur la façon dont les organisations exploitent et font évoluer leurs bases de connaissances.
FAQ
Quelle est la meilleure façon de structurer nos données et de garantir des réponses exactes aux employés ?
Dans une application comme Slite, vous structurez vos connaissances à l'aide de Channels, les sections de premier niveau de votre espace de travail. Voyez-les comme des dossiers. La hiérarchie du contenu est la suivante : Channels > Documents > Sous-documents.
Bonnes pratiques : restez simple au départ. Cartographiez d'abord votre contenu et votre audience. Le recoupement des deux forme le plan de vos channels. Visez un maximum de 10 documents de premier niveau par channel. Créez une page d'accueil pour chaque channel avec la commande IA /generate a directory.
Comment éviter les mauvaises réponses ?
Dans le cas de Slite Agent, la recherche sémantique couvre vos outils connectés (documents, Slack, tâches, tickets) et génère des réponses accompagnées de citations qui indiquent exactement d'où provient chaque élément. Elle utilise le RAG (Retrieval Augmented Generation) et respecte les permissions existantes, de sorte que les utilisateurs ne voient que des réponses issues de sources auxquelles ils ont accès. Les documents vérifiés sont mieux classés dans les résultats ; les documents obsolètes sont exclus, si bien que la qualité des réponses s'améliore à mesure que votre base de connaissances s'améliore. La vue d'ensemble « Ask Insights » montre aux administrateurs quelles questions sont restées sans réponse ou ont été signalées comme erronées, pour que vous sachiez exactement quel contenu créer ensuite.
Peut-on confier sa documentation interne à une base de connaissances LLM ?
La sécurité de la base de connaissances et la confiance sont souvent les premières préoccupations lorsqu'on introduit l'IA dans le travail quotidien. La bonne nouvelle, c'est que l'IA moderne adaptée aux entreprises est conçue avec la protection des données à l'esprit, à condition de choisir la bonne plateforme.
Est-il sûr d'utiliser les données de l'entreprise avec OpenAI ?
Oui, si vous utilisez les versions professionnelles (Enterprise) du service. Dès lors que vous payez pour le service, vous pouvez vous désengager des comportements et des parties du service jugés risqués : l'utilisation de vos données pour entraîner les modèles, la propriété des données, les normes de sécurité et les contrôles de conservation des données. Toute entreprise qui cherche à vous vendre un logiciel ou un service d'IA doit avoir pleinement traité ces exigences de sécurité.
Comment garder les informations sensibles confidentielles ?
Pour les utilisateurs de Slite qui utilisent aussi Slite Agent, celui-ci ne fait remonter que les informations qu'un utilisateur est déjà autorisé à voir. Il respecte les rôles existants, les règles d'accès et les permissions de dossiers dans tous les outils connectés, donc il ne crée aucun nouveau risque de sécurité ; il rend simplement l'information autorisée plus facile à trouver. Chaque réponse est accompagnée de citations renvoyant à la source d'origine, pour que rien ne ressemble à une boîte noire. Les utilisateurs peuvent vérifier l'exactitude, et le système de vérification de Slite maintient le contenu sur lequel l'IA s'appuie à jour et approuvé.